大模型从入门到精通|6 阶段系统化全路线指南(2026 最新落地版)
大模型从入门到精通|6 阶段系统化全路线指南(2026 最新落地版)
整体学习周期:零基础 6~8 个月可达到企业可上岗水平;有 Python / 深度学习基础可压缩至 3~4 个月。
核心原则:先会用→再懂原理→项目落地→工程部署→底层微调→赛道深耕,拒绝一上来死磕论文与数学,边实战边补理论,杜绝碎片化无效学习。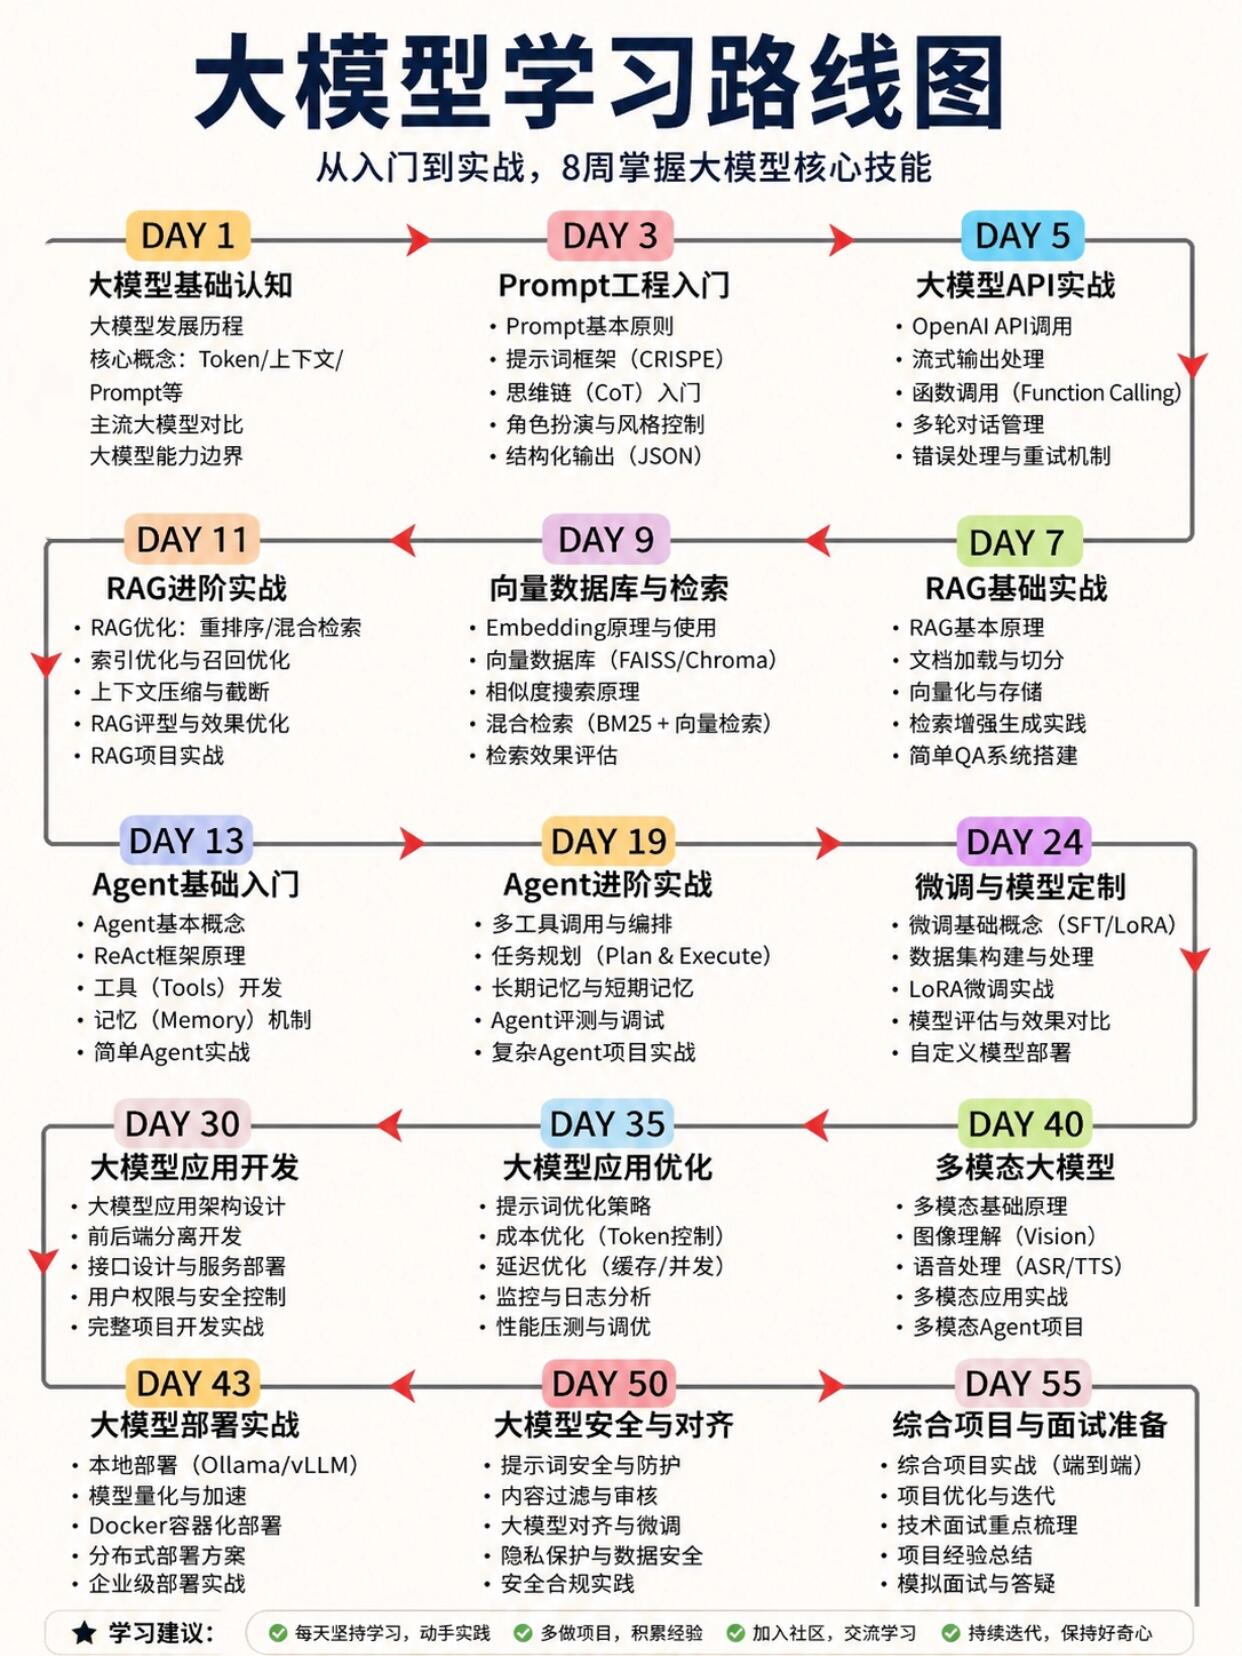
前置:3 类人群差异化起步方案
1. 纯小白(无编程、无 AI 基础)
起步顺序:Prompt 提示词工程 → Python 极简基础 → API 调用 → RAG 知识库项目 → 框架开发 → 微调部署
定位:优先做大模型应用开发、AI 产品、提示工程师,门槛最低、变现最快。
2. 程序员(Java/Python/ 前端有开发基础)
起步顺序:直接对接 LangChain/LlamaIndex 框架 → 对接开源模型 API → 向量库 + RAG 全栈项目 → Agent 智能体 → 私有化微调部署
定位:原有技术栈 + 大模型能力叠加,做 AI 后端、智能应用开发。
3. 计算机 / AI 相关专业(懂深度学习)
起步顺序:吃透 Transformer 架构 → 预训练 / 微调原理 → 分布式训练 → RLHF 对齐、多模态大模型、论文复现
定位:冲击大模型算法工程师、基座模型研发岗位。
第一阶段:入门认知 & Prompt 工程(0~1 个月,零基础必最先学)
一、核心通识概念(彻底看懂行业术语)
1.基础定义
LLM 大语言模型、Token(字词切分单位)、上下文窗口 Context Window、幻觉 Hallucination、温度 Temperature、Top-P/Top-K 采样、基座大模型、微调模型、多模态大模型、SAFE 对齐、Agent 智能体、RAG 检索增强生成。
2.核心逻辑:大模型本质是基于上文预测下一个字符,所有对话、写作、推理全部基于该机制。
二、Prompt 提示词(人与大模型的交互语言,零基础最快上手)
必学 5 类核心写法
1.角色设定法:给模型固定身份(法律顾问、数据分析师、文案编辑),输出高度专业化内容;
2.零样本 Zero-shot:直接下达指令,无示例;少样本 Few-shot:附带 2~3 个标准答案示例;
3.思维链 CoT:让模型分步思考,解决数学、逻辑、推理类问题;
4.结构化输出:强制 JSON / 表格 / 列表格式,方便程序解析;
5.工具调用 Function Call:让模型调用查天气、查数据库、联网搜索等外部工具。
实操任务
每天用 GPT / 文心一言 / 通义千问完成 3 个场景:公文撰写、数据整理、问答答疑;搭建个人提示词模板库。
阶段产出
可独立用提示词解决办公、文案、数据分析、简单编程需求;能区分模型参数对回答效果的影响。
第二阶段:工具编程筑基(1~2 个月,打通代码基础环境)
1. Python 极简刚需学习(不用学全栈,够用即停)
核心掌握:基础语法、列表 / 字典、函数、文件读写、字符串处理;
必学三方库:
NumPy:矩阵数值运算(模型张量底层)
Pandas:文本数据集清洗、去重、格式处理
Requests:HTTP 接口调用,对接各大模型 API。
2. 开发环境标配(统一环境,避免配置踩坑)
1.工具:VS Code + Anaconda(虚拟环境隔离)+ Git(版本管理)
2.系统:优先Linux/WSL 子系统,Windows 原生极易出现 CUDA、环境报错;训练推荐租用 AutoDL、阿里云按需 GPU 算力,无需个人高价显卡。
3.必备 Linux 命令:ssh 远程连接、tmux 后台挂进程、docker 容器基础操作。
3. 第一个最小 Demo 项目
调用DeepSeek / 通义千问 / OpenAI 官方 API,写 Python 脚本实现:输入问题→接口请求→打印流式回答,完成从手动网页对话到程序自动化调用。
第三阶段:应用开发核心|RAG 知识库 + Agent 智能体(2~4 个月,求职核心项目)
本阶段是企业需求量最大的落地方向,简历核心作品集全部出自这里。
模块 1:RAG 检索增强生成(解决大模型知识滞后、幻觉两大痛点)
标准四步流程
文档加载 → 文本分块切片 → Embedding 向量化嵌入 → 存入向量数据库;
用户提问→问题向量化→向量库相似度检索→把参考文档塞进 Prompt→大模型生成答案。
必学技术栈
1.框架:LangChain(主流首选)、LlamaIndex
2.向量数据库:轻量 Chroma、FAISS;企业级 Milvus、Qdrant
3.嵌入模型:bge、gte 中文开源 Embedding 模型
可直接落地项目
PDF 文档知识库问答、企业内部规章智能客服、论文文献检索助手、本地个人笔记 AI 助手。
模块 2:Agent 智能体(让大模型具备自主规划、工具调用、多步骤任务能力)
1.核心范式:ReAct(思考 + 行动)、Plan-Solve、多智能体协作;
2.核心能力:联网搜索、代码执行、数据库查询、文件读写、自动化办公;
3.进阶:低代码工作流编排(Coze 扣子、Dify)可视化搭建 Agent 应用,无代码快速交付业务系统。
实战项目
AI 数据分析助手(上传 Excel 自动出报表 + 分析结论)、个人日程规划助理、多工具联动办公机器人。
阶段硬性产出
2 个可部署上线完整项目:私有化本地 RAG 系统、单 Agent 工具调用程序,打包 GitHub 源码 + 演示视频,写入简历。
第四阶段:模型微调 & 轻量化优化(4~6 个月,垂直领域定制能力)
API 调用只能用官方基座,微调可以基于开源模型打造专属行业模型,是区分普通调包工程师与资深开发的分水岭。
一、主流微调方案(按上手难度排序)
1.LoRA 低秩微调(首选):只训练少量参数,显存占用极低,单张 16G 显卡即可运行,金融、医疗、法律垂直场景通用;
2.Adapter 微调:在 Transformer 层插入适配器模块,冻结主模型权重;
3.全参数微调:修改模型全部权重,需要多卡分布式算力,适合基座模型迭代;
4.指令微调 SFT:构造问答数据集,让模型对齐人类指令习惯。
二、主流开源基座模型(国内优先)
通义 Qwen 系列、DeepSeek、Llama3、GLM、MiniCPM,全部支持开源商用免费使用。
三、配套工具链
微调框架:LLaMA Factory、Transformers、PEFT(Hugging Face 官方工具)
数据集处理:Datasets 库,清洗、过滤、格式统一训练语料
模型轻量化:INT4/INT8 量化、模型蒸馏、剪枝,把几十 G 大模型压缩到几 G,可在笔记本、手机端侧部署。
实战项目
法律条文专属小模型、电商客服定制微调模型、本地离线可运行轻量化对话大模型。
第五阶段:工程化部署 LLMOps(6~7 个月,企业运维落地必备)
学会把训练好的模型封装成服务,内网私有化部署、并发压测、监控运维,适配政企内网无外网环境。
1.接口封装:FastAPI/Flask 把模型推理封装 HTTP 接口,前后端对接;
2.容器打包:Docker 制作镜像,一键迁移服务器部署;
3.推理加速:TensorRT、vLLM、Text Generation Inference,提升吞吐量、降低显存占用;
4.服务架构:多模型负载均衡、流式输出 SSE、会话上下文缓存、用户权限鉴权;
5.LLMOps 流水线:数据管理→训练任务调度→模型版本管理→灰度发布→效果监控全流程。
第六阶段:底层原理 & 高阶深耕(7~8 个月,精通分水岭,可选深造)
1. 核心底层架构(必啃经典论文)
《Attention Is All You Need》 Transformer 原始论文,彻底理解自注意力机制、多头注意力、编码器解码器结构;
弄懂:词嵌入 Embedding、位置编码、前馈网络、掩码 Mask、上下文计算逻辑。
2. 大模型训练全链路
1.预训练 Pre-training:海量无标注文本训练,学习通用语言规律;
2.监督微调 SFT:标注问答数据对齐指令;
3.RLHF 人类反馈强化学习:打分排序→奖励模型→强化学习优化输出;
4.MoE 混合专家模型:稀疏激活,超大参数模型主流架构(DeepSeek、GPT4 均采用)。
3. 前沿拓展方向(任选一条深耕)
多模态大模型:图文理解、文生图、视频大模型(CLIP、SAM、Qwen-VL);
端侧大模型:手机、嵌入式设备离线大模型部署;
分布式训练:DeepSpeed、Megatron-LM 多机多卡集群训练;
大模型安全合规:数据脱敏、提示词注入防御、内容风控、隐私计算;
评测体系:构建自动化评测集,量化模型回答准确率、幻觉率。
4. 学术进阶
定期阅读 ArXiv、NeurIPS/ICML/ACL 顶会论文,参与开源项目提交 PR,可转向算法研发、科研方向。
分阶段必备书籍 & 免费学习资源
入门应用向
1.《大模型应用开发极简入门》:国内实战导向,零基础友好
2.《Natural Language Processing with Transformers》Hugging Face 官方工具书
3.OpenAI 官方 Prompt 工程公开课(Coursera 免费)
原理深度学习向
1.《深度学习》花书(基础理论工具书)
2.《动手学深度学习》李沐,B 站配套视频可同步观看
3.《大语言模型实战:技术、架构与案例》
开源社区 & 工具总站
1.Hugging Face Hub:全球最大开源模型、数据集仓库
2.Datawhale:国内组队学习、开源教程项目
3.GitHub:LangChain、LLaMA Factory、vLLM 官方仓库
三大主流就业岗位 & 能力匹配(精准对标求职)
1. 大模型应用开发工程师(入行首选,岗位最多)
核心技能:Python、LangChain、RAG、向量库、Agent、API 开发、Docker 部署
简历项目:企业知识库问答、智能客服、自动化办公 Agent
2. LLM 算法工程师(进阶高薪岗)
核心技能:Transformer 原理、数据集构建、LoRA / 全量微调、RLHF、分布式训练、论文复现
适合:计算机本硕、AI 相关专业,目标基座模型研发
3. LLMOps 运维工程师(稀缺竞争小)
核心技能:GPU 集群调度、推理加速、容器化部署、模型版本管理、算力资源优化
侧重工程运维,门槛低于纯算法,溢价明显。
新手 9 条避坑红线(少走 80% 弯路)
❌ 不要开篇硬啃数学与论文,先做可运行项目,遇到知识点再回溯补学;
❌ 拒绝碎片化刷短视频知识点,按阶段系统化学习,搭建完整知识树;
❌ 只看视频不敲代码,大模型属于工程实践学科,每一个框架必须手动跑通 Demo;
❌ 盲目购买高端显卡,前期训练全部使用云算力按需付费,成本更低;
❌ 项目只做 Demo 不封装上线,简历必须附带可演示、可开源的成品项目;
❌ 混用过多小众框架,吃透 LangChain+Transformers 两大核心即可通用绝大多数场景;
❌ 忽视幻觉、数据合规问题,企业落地首要考量风控与隐私安全;
❌ 一味追求大参数模型,轻量化、离线端侧模型是中小企业刚需;
❌ 学完不沉淀作品集,GitHub + 演示链接是面试核心凭证。
极简时间线总览
第 1 月:吃透 Prompt,会用各大商用大模型
第 2~3 月:Python+API 调用,完成首个对话脚本
第 3~5 月:RAG+Agent 两大核心项目,搭建简历核心作品
第 5~6 月:LoRA 微调 + 模型量化,掌握定制模型能力
第 6~7 月:Docker+FastAPI 部署,实现私有化服务上线
第 7~8 月:Transformer 底层原理 + 前沿方向细分深耕,完成面试体系梳理
-
 LLM大语言模型典型案例分析|落地实战复盘
概述:本文聚焦2025-2026年已商业化落地、具备真实数据、可复用落地逻辑的四大LLM标杆案例,覆盖金融风控、工业智造、在线教育、智能客服四大核心赛道。统一采用「项目痛点→技术架构→落地流程→落地成效→现存问题→...
-
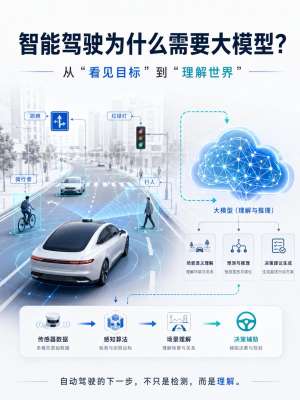 LLM大语言模型落地案例分析报告—以家用智能座舱系统为例
一、案例概述随着生成式人工智能技术快速迭代,LLM大语言模型已从通用对话场景,深度下沉至车载智能座舱垂直领域。传统车机语音系统多为固定指令匹配、语义理解僵化、交互生硬,无法满足家庭多成员...
-
 LLM大模型工具推荐2026完整版|全场景选型指南
2026 LLM选型核心标准:不再只看对话流畅度,重点看长文本理解、真实知识库RAG、多模态质量、Agent智能体能力、国产化合规、稳定输出。以下为目前全网综合体验最强、落地最稳、适配各行各业的主流LLM工具,分场景精准...
-
 LLM大模型全行业应用场景(2026完整版|落地可用)
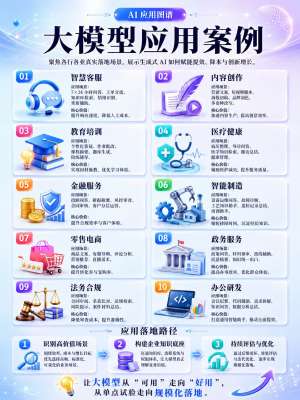
本文整理通用+政企+产业+ToB+ToC+车端+教育+医疗+文旅+开发运维全维度LLM落地场景,全部为当前可商业化、可项目落地的真实场景,无概念虚标,适合项目申报、方案撰写、产品规划、赛道调研使用。一、通用基础能力场景...
-
 LLM大语言模型深度解析|2026完整版全解
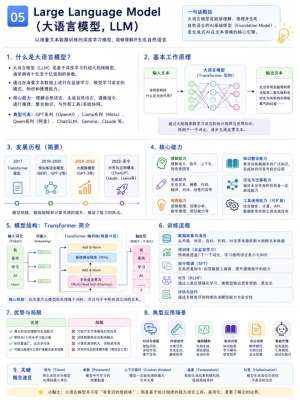
核心前言:2026年是大语言模型从通用对话工具彻底转向产业智能底座、Agent自主生产力的关键拐点。行业认知已全面升级:LLM不再是“会聊天的AI”,而是基于海量数据概率学习、具备语义理解、逻辑推理、工具调用、自主规划、...
-
 LLM大模型落地最佳实践|全指南
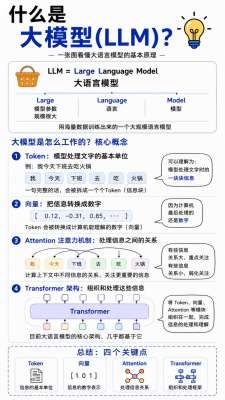
前言:大模型(LLM)已经从“技术demo”进入工业化、工程化、业务化落地阶段。绝大多数企业落地失败,并非模型能力不足,而是缺少标准化落地范式、Prompt混乱、向量库滥用、微调无策略、推理成本失控、幻觉风险未治理。本文总结行业...