大模型最佳实践|个人高效使用+企业工程落地全指南(2026实战版)
大模型最佳实践|个人高效使用+企业工程落地全指南(2026实战版)
大模型落地的核心最佳实践:不盲目追大模型、不依赖纯prompt、不裸机上线、不一次性交付。无论是个人提效、团队协作,还是企业商业化落地,所有成熟的大模型应用,都遵循一套标准化、可复用、低幻觉、高稳定的实战体系。本文整合行业通用最优方案,分层讲解使用、工程、落地、安全、迭代五大维度最佳实践。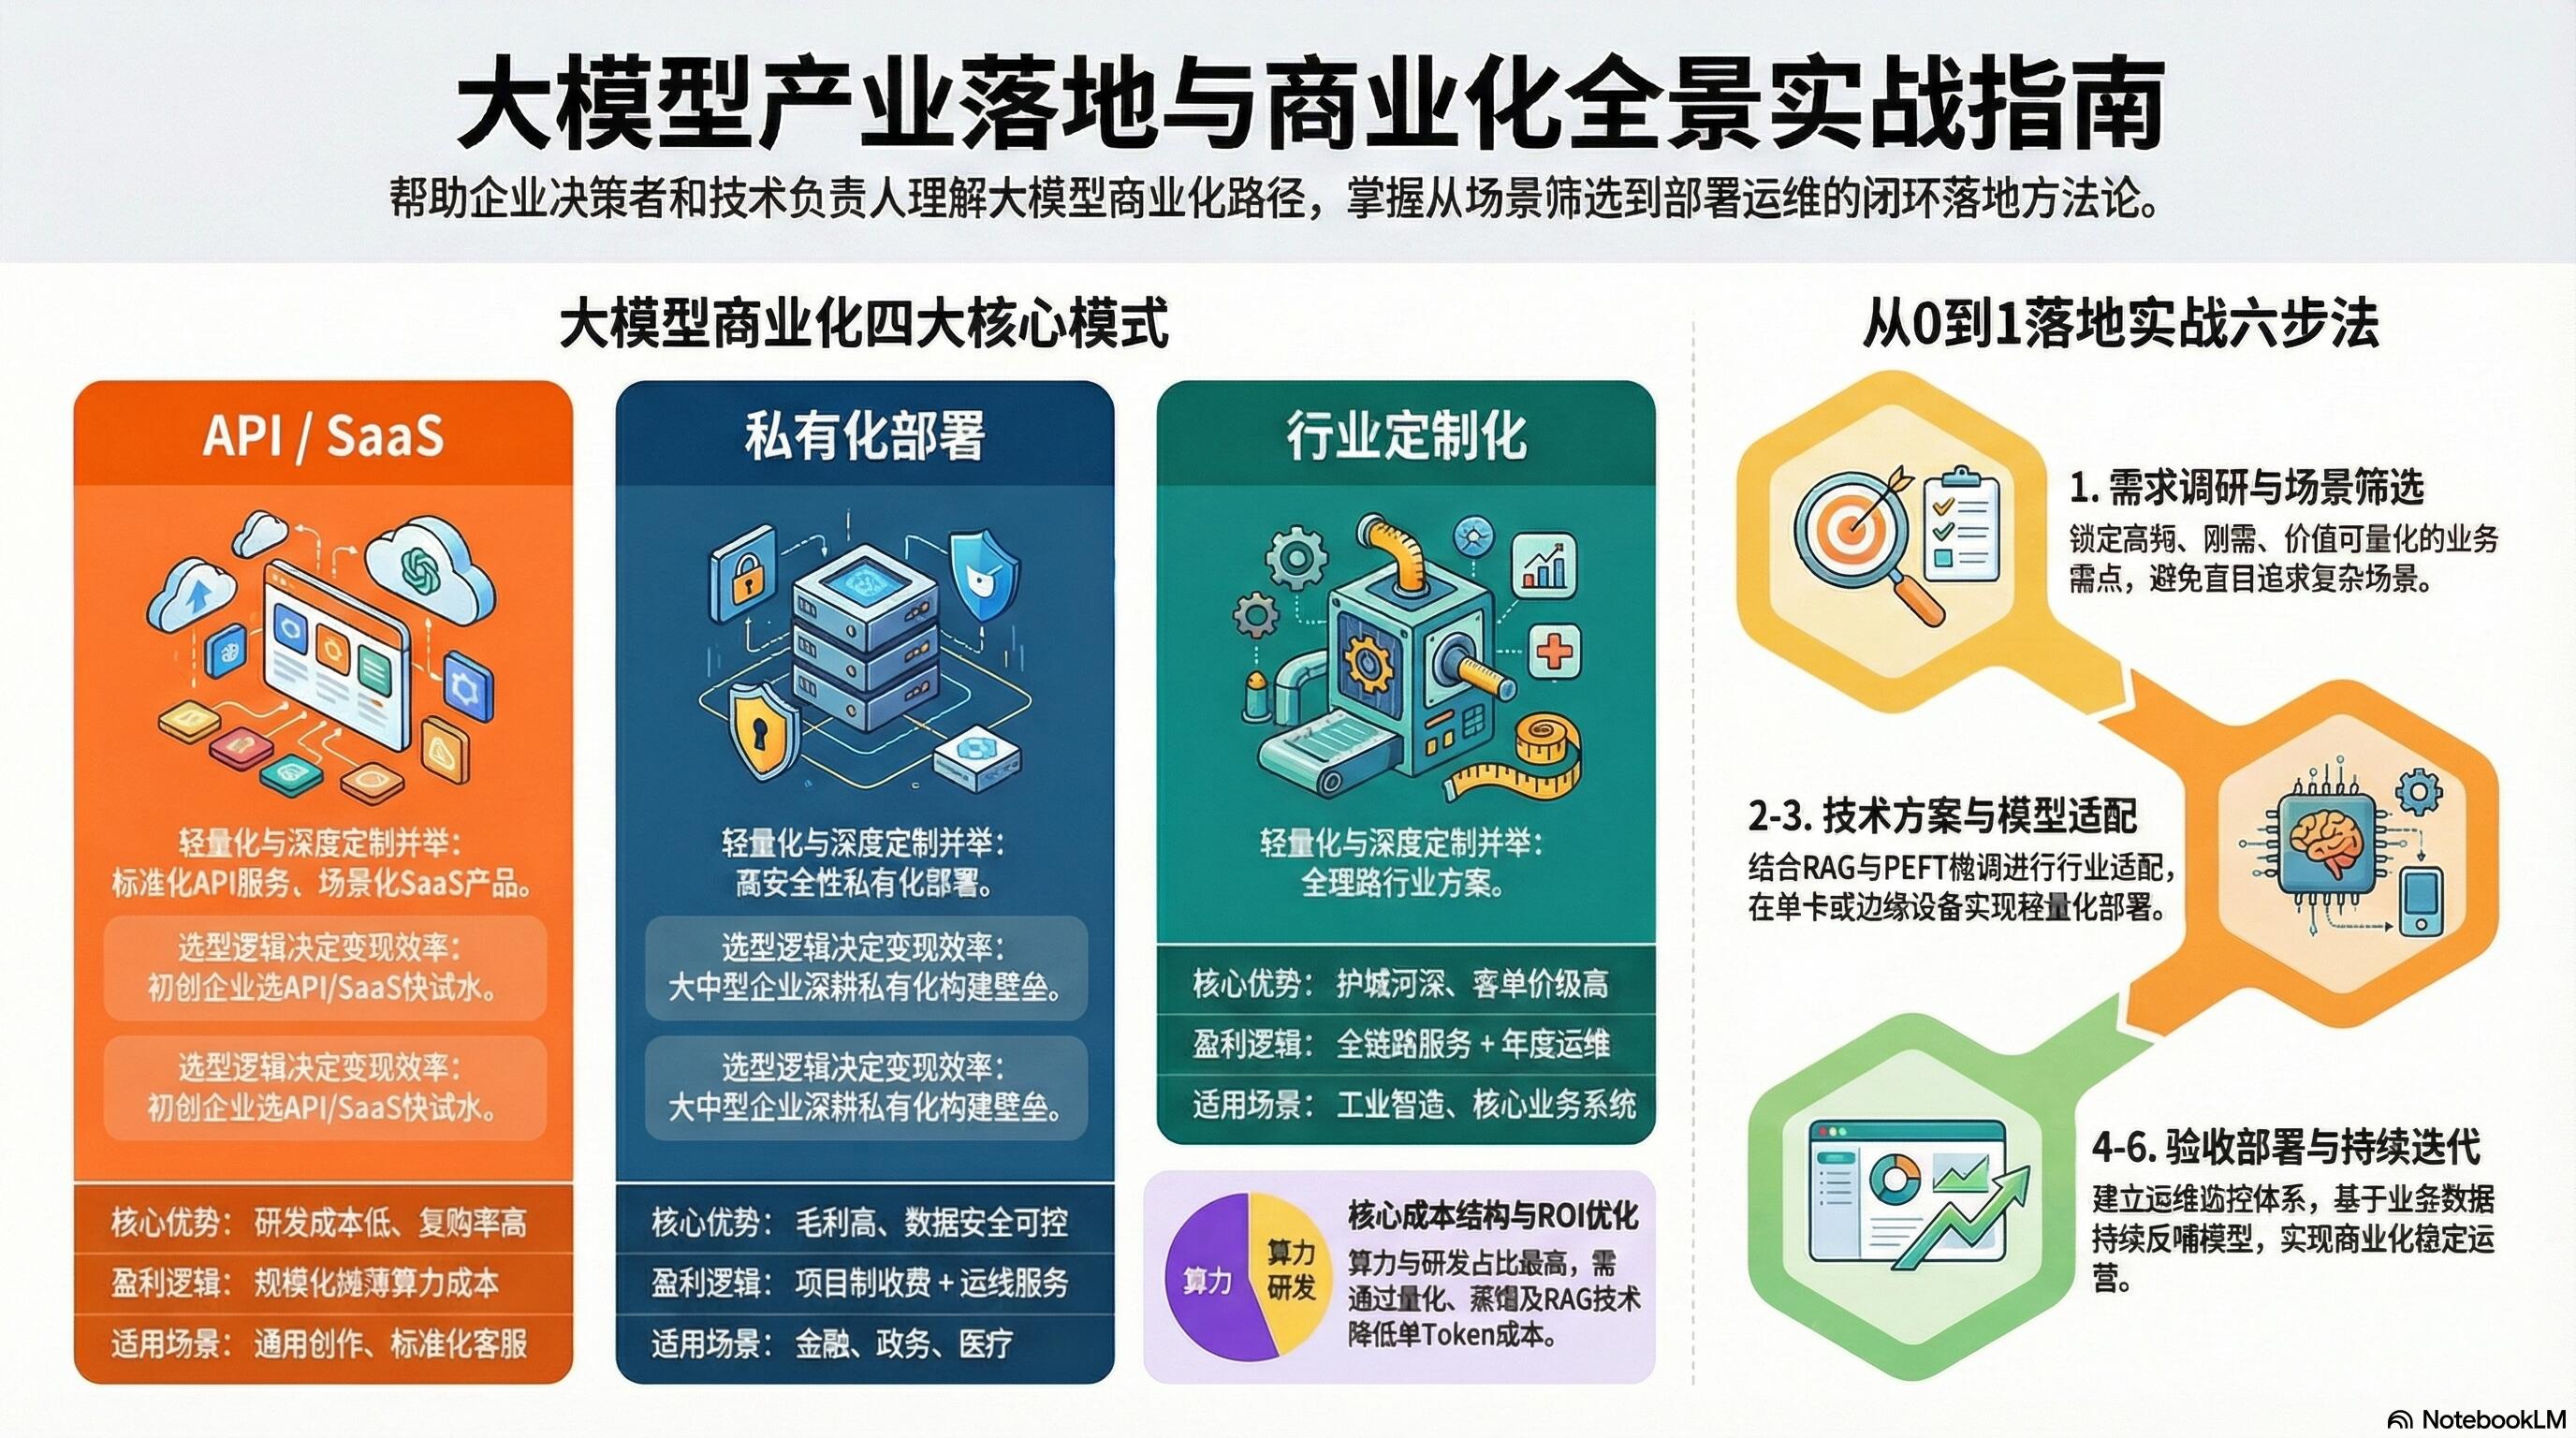
一、基础使用最佳实践(个人/通用场景)
核心原则:精准指令、结构化输出、思维引导、结果校验,告别模糊提问、无效对话、AI空话输出。
1、标准化Prompt五要素(必用)
高质量提问必须包含:角色设定 + 明确任务 + 详细上下文 + 输出格式约束 + 限制条件,避免模型自由发挥。
• 角色设定:指定专业身份,锁定回答专业度(分析师、文案、工程师、讲师)
• 任务明确:拒绝“帮我写一下”,改为“撰写、拆解、对比、复盘、优化”等具体动作
• 上下文完整:提供背景、目标、受众、限制条件,减少模型脑补
• 格式强制:指定markdown、分点、表格、步骤式、报告式输出
• 边界约束:禁止空话、禁止杜撰数据、禁止无关拓展、控制字数范围
2、复杂问题强制使用CoT思维链
逻辑分析、方案拆解、推理计算、行业研判类问题,必须开启分步推理:先拆解、再推导、最后总结,可大幅降低逻辑错误与幻觉概率。
3、结果二次校验机制
所有知识性、数据性、结论性内容,必须附加校验指令:核对信息真实性、标注不确定内容、区分事实与推演、列出参考依据,杜绝AI杜撰。
4、拒绝一次性对话,采用迭代优化
初稿生成→结构优化→细节填充→语言润色→合规修正→最终定稿,迭代式输出比一次性生成质量提升80%以上。
二、企业应用层最佳实践(业务落地核心)
核心原则:场景优先、价值前置、轻量化落地、小步快跑迭代,避免大而全、重投入、无产出的无效AI建设。
1、场景选型最优标准
优先落地高重复、高人力、高标准化、低创造性场景:文案生成、数据整理、报表复盘、客服问答、知识库问答、代码辅助、内容审核、会议纪要。
谨慎落地:强决策、强合规、强医疗、强金融等高风险场景,必须配套人工审核。
2、落地路径最佳范式:先赋能、后替代、再创新
• 第一阶段:辅助提效(AI做初稿、人工做终审)
• 第二阶段:流程替代(标准化流程全自动运行)
• 第三阶段:业务创新(AI驱动新场景、新服务、新能力)
3、坚决规避“纯大模型裸奔上线”
纯大模型直接对话上线,必然出现幻觉、过时知识、答非所问、违规内容。企业上线必须搭配:知识库、检索、风控、日志、人工兜底五层体系。
三、工程架构最佳实践(稳定、低幻觉、高性能)
行业通用最优架构:Prompt工程 + RAG检索增强 + 轻量化微调 + 工具调用 + 风控观测组合方案。
1、RAG优先于微调(低成本高收益)
私有知识、实时数据、行业资料更新场景,优先使用RAG检索增强,无需大量标注数据、训练成本低、迭代快、可实时更新知识,是企业落地首选方案。
RAG最佳流程:文档清洗→语义分块→向量化存储→相似度检索→上下文拼接→模型生成→结果溯源。
2、微调仅用于固定任务范式
回答风格、固定话术、专属任务范式、垂直行业话术统一,适合SFT监督微调;不用微调解决知识更新问题,低效且滞后。
3、工具调用规范化
数据计算、实时查询、接口数据、联网资讯,必须调用工具,禁止模型脑补,彻底解决时效性、准确性短板。
4、分层模型调度策略
简单任务用轻量模型、复杂推理用高阶模型、高频接口做缓存、长文本做分段解析,兼顾成本、速度与效果,避免全员高配模型造成资源浪费。
四、安全与合规最佳实践(企业红线)
大模型企业落地,合规优先于效果、安全优先于体验。
1、数据安全三不原则
• 不上传核心机密数据
• 不输入用户隐私明文
• 不公开训练企业私有数据
2、内容风控双层拦截
输入侧风控:拦截违规提问、敏感词、恶意诱导prompt;
输出侧风控:过滤虚假、违规、偏见、不实内容,杜绝AI造谣与不当输出。
3、全链路日志可溯源
所有对话、检索、生成结果、用户操作全程留痕,支持审计、复盘、问题定位,满足企业合规与监管要求。
4、幻觉治理标准化
• 所有知识性输出必须标注来源
• 不确定内容明确提示风险
• 禁止模型杜撰数据、案例、政策、人名
• 重要结论强制人工复核
五、迭代与运维最佳实践(长期稳定运营)
1、数据持续迭代
沉淀优质问答、修正错误输出、补充场景案例,持续优化知识库与prompt模板,实现模型效果越用越好。
2、A/B测试常态化
新prompt、新模型、新策略上线必须做对照测试,量化准确率、通过率、用户满意度,以数据迭代而非主观判断。
3、用户反馈闭环
建立差评、错误、无效回答的快速修复通道,问题日清日结,避免同类错误反复出现。
六、行业通用避坑黑名单(高频错误)
1、只靠Prompt解决所有问题,无知识库、无检索、无校验
2、盲目做大模型全量微调,成本高、迭代慢、效果差
3、直接上线裸模型,无风控、无兜底、无日志
4、一次性开发上线,无迭代、无复盘、无优化机制
5、混淆模型能力边界,让AI承担强决策、高风险工作
6、忽视数据脱敏,导致企业隐私与用户信息泄露
七、终极最佳实践总结
个人最佳实践:结构化提问 + 思维链推理 + 迭代优化 + 结果校验
企业最佳实践:场景轻量化落地 + RAG优先 + 工具增强 + 双层风控 + 数据迭代闭环
长期核心逻辑:大模型不是万能工具,而是可工程化、可管控、可迭代、可合规的智能生产力底座,所有最佳实践最终指向:更准、更稳、更安全、更低成本、更高业务价值。
-
 LLM大语言模型典型案例分析|落地实战复盘
概述:本文聚焦2025-2026年已商业化落地、具备真实数据、可复用落地逻辑的四大LLM标杆案例,覆盖金融风控、工业智造、在线教育、智能客服四大核心赛道。统一采用「项目痛点→技术架构→落地流程→落地成效→现存问题→...
-
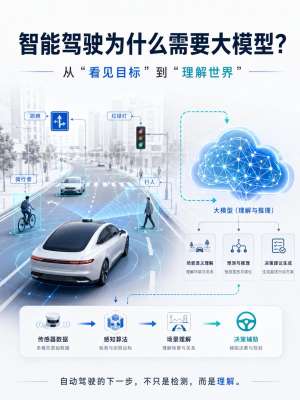 LLM大语言模型落地案例分析报告—以家用智能座舱系统为例
一、案例概述随着生成式人工智能技术快速迭代,LLM大语言模型已从通用对话场景,深度下沉至车载智能座舱垂直领域。传统车机语音系统多为固定指令匹配、语义理解僵化、交互生硬,无法满足家庭多成员...
-
 LLM大模型工具推荐2026完整版|全场景选型指南
2026 LLM选型核心标准:不再只看对话流畅度,重点看长文本理解、真实知识库RAG、多模态质量、Agent智能体能力、国产化合规、稳定输出。以下为目前全网综合体验最强、落地最稳、适配各行各业的主流LLM工具,分场景精准...
-
 LLM大模型全行业应用场景(2026完整版|落地可用)
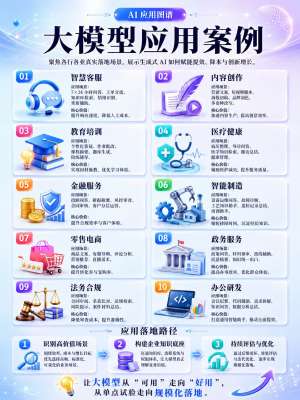
本文整理通用+政企+产业+ToB+ToC+车端+教育+医疗+文旅+开发运维全维度LLM落地场景,全部为当前可商业化、可项目落地的真实场景,无概念虚标,适合项目申报、方案撰写、产品规划、赛道调研使用。一、通用基础能力场景...
-
 LLM大语言模型深度解析|2026完整版全解
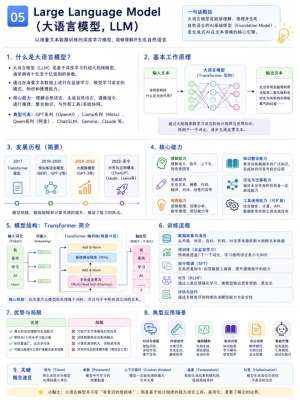
核心前言:2026年是大语言模型从通用对话工具彻底转向产业智能底座、Agent自主生产力的关键拐点。行业认知已全面升级:LLM不再是“会聊天的AI”,而是基于海量数据概率学习、具备语义理解、逻辑推理、工具调用、自主规划、...
-
 LLM大模型落地最佳实践|全指南
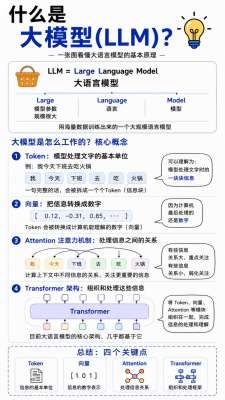
前言:大模型(LLM)已经从“技术demo”进入工业化、工程化、业务化落地阶段。绝大多数企业落地失败,并非模型能力不足,而是缺少标准化落地范式、Prompt混乱、向量库滥用、微调无策略、推理成本失控、幻觉风险未治理。本文总结行业...