大模型全维度深度解析(2026 最新完整版)
大模型全维度深度解析(2026 最新完整版)
一、基础定义与本质内核
大语言模型(LLM)本质依托Transformer 注意力架构,通过海量文本数据预训练,学习语言语法、逻辑、常识、因果与人类知识分布,核心机制是预测下一个最合理 Token,实现文本生成、理解、归纳、推理、创作、工具调用。
2026 年行业核心范式彻底切换:从单轮对话问答 → 多模态统一基座 → AI 智能体 Agent 自主闭环执行任务 →
世界模型预判环境状态,不再只是 “会说话”,而是具备规划、拆解、工具调用、多步骤自主完成业务流程的数字生产力单元。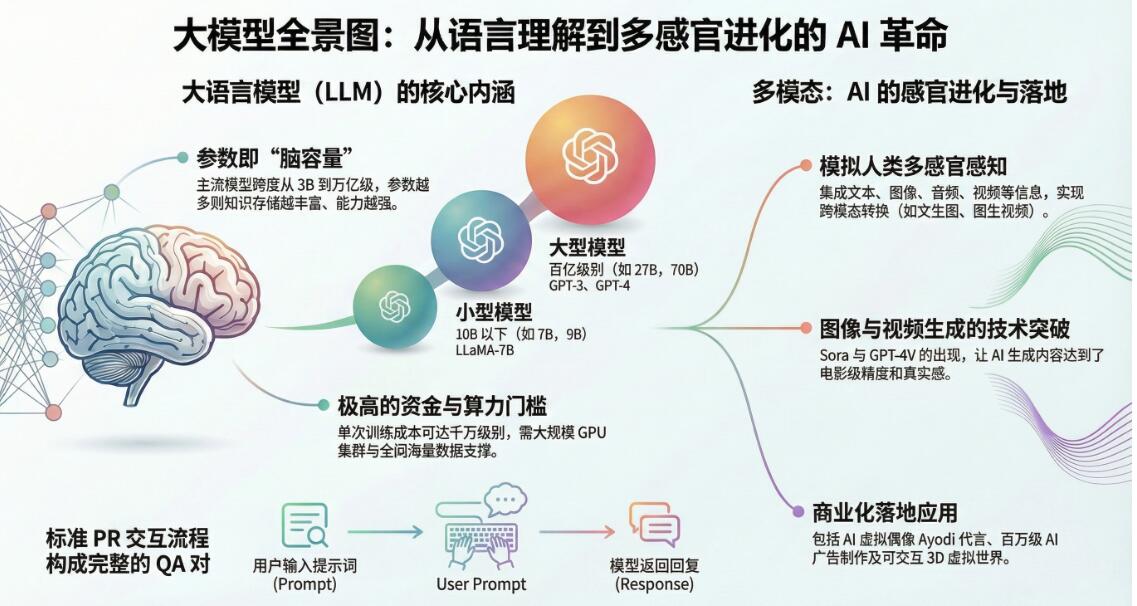
三代发展阶段
1.1.0 参数堆砌期(2022 前):GPT-3 为代表,靠扩大参数量提升能力,稠密全参数激活,算力消耗极大,仅支持基础问答写作。
2.2.0 对齐微调期(2023-2025):RLHF 人类反馈对齐,解决输出有害、胡说、格式混乱问题;RAG 检索增强落地,缓解模型幻觉。
3.3.0 智能体 + 稀疏架构期(2026 至今):MoE 混合专家架构成为标配;内置深度思考(慢思考)机制;原生支持工具调用、软件操作、跨模型协同;端侧轻量化离线大模型规模化商用。
二、核心底层技术架构拆解
1. 主干网络:主流三大基础架构
(1)传统稠密 Transformer(存量主流)
每一次输入推理都会激活模型全部参数,优点逻辑稳定易调试;缺点参数量越大推理成本指数上涨,长上下文算力浪费严重,目前仅中小体量模型使用。
(2)MoE 混合专家架构(2026 行业标配)
总参数规模极大,但通过门控网络动态匹配输入内容,仅激活少量专家子模块参与计算。
代表:阿里 Qwen3.5 Max 总参 397B,激活仅 17B,推理成本下降 40%;美团 LongCat 万亿参数 MoE 大模型,依托国产 5 万卡集群完成全链路训练。
核心价值:大模型能力 + 小模型推理成本,是基座降本最关键路线。
(3)SSM 状态空间模型(长文本专用)
替代部分自注意力机制,解决超长上下文(百万字以上)算力爆炸问题,适合知识库、合同审核、研报通读、代码库解析场景,Kimi、DeepSeek 均深度融合该结构。
2. 四层标准工程化技术链路(企业落地必用)
第一层:基座预训练(Foundation Base)
使用全网合规海量文本、书籍、网页、论文、代码做无监督预训练,搭建通用知识底座;不面向具体业务,只学习通用世界知识。
第二层:监督微调 SFT
投喂人工标注问答、指令样本,让模型听懂人类指令,规范输出格式、语气、结构。
第三层:人类反馈对齐 RLHF / DPO
区分优质回答与劣质回答,惩罚幻觉、暴力、偏见、错误信息,大幅降低胡说概率;2026 主流直接采用 DPO 直接偏好优化,省去奖励模型环节,训练效率翻倍。
第四层:推理增强与外部能力扩展
1.RAG 检索增强生成
接入企业私有知识库、文档、数据库,回答时先检索内部资料再生成内容,从根源解决 “模型知识库过时、私有信息无法调取、严重幻觉” 三大痛点。
标准流程:文档切片→向量化 Embedding 存入向量库→用户问题向量化检索 TopN 片段→送入大模型生成答案→结果重排序降噪,优化后回答准确率可从 68% 提升至 89%。
2.Function Calling 工具调用
模型可自主判断需要联网查天气、查数据、调用 Excel、调用接口、查询数据库、发起邮件,打破模型静态知识局限。
3.Agent 智能体编排(2026 核心增量)
模型自主拆解复杂目标→分步制定计划→调用对应工具→校验结果→迭代修正→输出最终结果,可无人值守完成报销、合同审查、运维巡检、数据分析、短视频全流程生产。
主流编排框架:LangGraph、AutoGen、CrewAI、Dify 低代码可视化平台。
3. 多模态大模型原生融合(从拼接走向统一表征)
早期多模态 = 文本大模型 + 独立图片编码器拼接;
新一代架构文 / 图 / 音 / 视频 / 红外 / 点云共用一套主干网络,统一 Token 空间,可一次性读取数十张图片、长 PDF、连续视频流并理解时序逻辑。
典型能力:工业设备异响 + 画面双维度故障诊断、短视频脚本一键生成 + 画面分镜匹配、票据 OCR 自动提取信息归档。
三、算力硬件底座:芯片与集群格局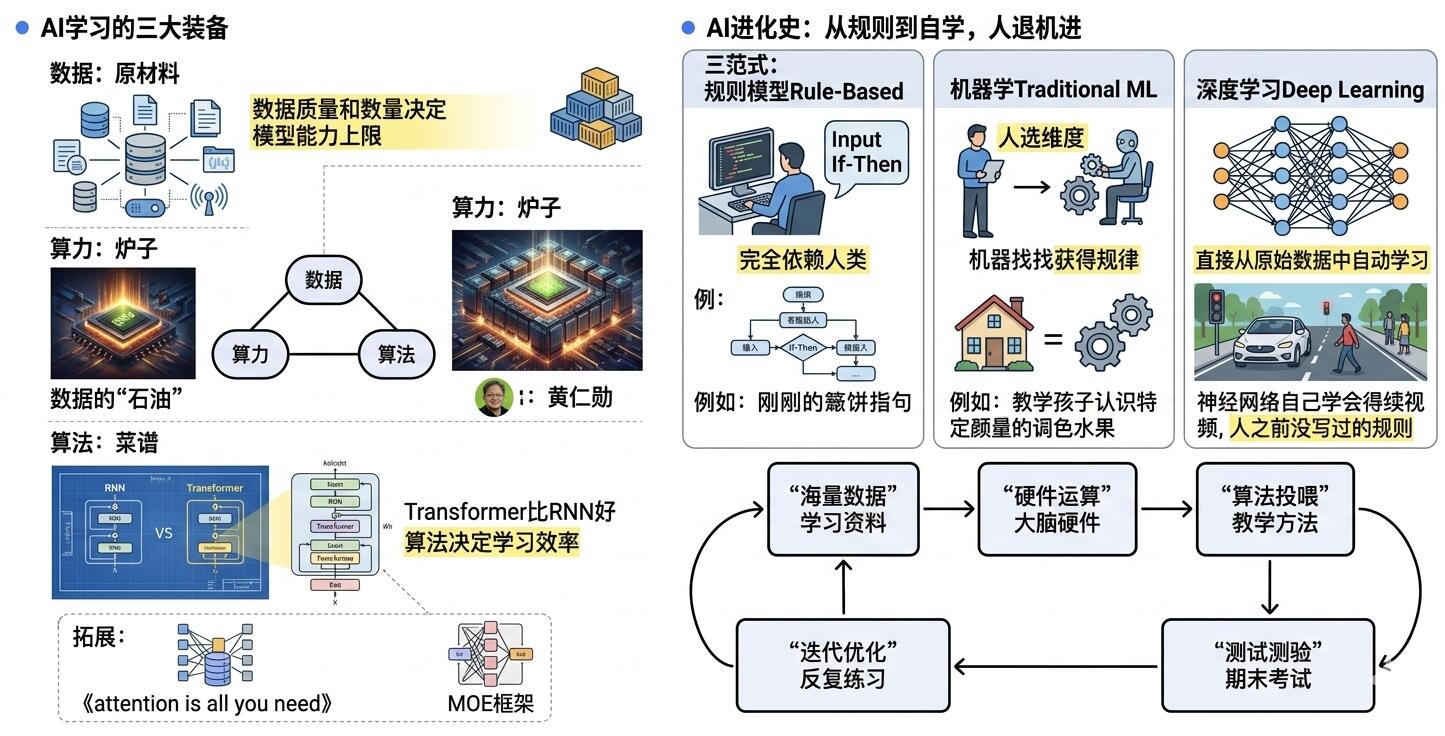
1. 训练端
英伟达 H100/H200 依旧垄断超大规模基座训练;国内海光、昇思、壁仞逐步适配 MoE 大模型训练,十五五专项基金重点扶持国产算力集群。
2. 推理端(竞争完全放开)
专用 ASIC 推理芯片、存算一体、SSD 内存缓存扩容内存墙,形成英伟达高端卡 + 国产推理芯片 + 端侧 NPU三方瓜分市场,推理硬件单价大幅下行。
3. 组网支撑
超算智算中心统一 Leaf-Spine 叶脊网络架构,RoCE 无损以太网保障集群多卡通信无丢包,万卡以上训练集群强制无收敛组网。
四、全球第一梯队主流模型阵营(2026 最新格局)
海外闭源头部
1.OpenAI GPT-5.5 /o1 系列
强项:深度思考推理、复杂数学逻辑、软件操作 Agent、多模态视频生成;缺点中文本土化一般,API 资费偏高。
2.Anthropic Claude Fable 5
超长上下文百万字符无损读取,法律文书、合同、财报精读行业第一,合规安全阈值极高,政企涉密文档场景首选。
3.Google Gemini 3
原生多模态最强,视频实时理解、机器人具身智能、世界模型研发领先。
国内四大巨头基座(生态闭环 + 政企 B 端主力)
1.字节跳动|豆包(Seed 基座)
C 端月活 3.45 亿居国内第一;API 公有云市场份额 46.4% 排名首位;优势多模态内容创作、短视频素材、图文生成、飞书办公协同;产品迭代速度行业顶尖。
2.阿里|通义千问 Qwen3.6
国内开源生态最强,全系列权重开放下载;日均 API 调用 15 亿 +,服务 9 万 + 企业;阿里云深度绑定政务、金融、工业数字化,私有化部署方案成熟。
3.腾讯|混元 Hy3
依托微信小程序生态,主打 C 端轻量化智能体、企业微信办公助手;一季度 319 亿资本开支全部倾斜 AI 算力与模型训练,重点布局 Agent + 社交场景打通。
4.百度|文心一言 ERNIE 5.0
知识图谱积淀最深,搜索数据原生加持;政企招投标、政务公文、文旅宣传传统项目落地量领先。
国内技术新锐(纯技术突围,无天然流量入口)
1.DeepSeek V4 Pro
推理、代码、数学能力国产第一梯队;训练成本仅为 GPT-4 约 1/20;开源版本社区热度极高,海外开发者广泛采用。
2.智谱 GLM-5.2
清华技术背书,多模型互联调度、科研论文、教育场景优势明显,股东包含腾讯、蚂蚁、美团等多家产业资本。
3.月之暗面 Kimi
超长上下文轻量化标杆,主打文档批量解析、本地部署,中小企业知识库首选。
4.MiniMax
语音全双工交互、虚拟数字人对话底层模型优势突出。
五、五大商业化落地场景(从概念到可量化营收)
1. 公有云 API 调用(最基础商业模式)
按 Token 计费,企业按需接入无需自建算力基座;价格持续内卷,主流大模型输入百万 Token 定价降至几元级别。
2. 私有化本地部署(政企刚需)
数据不出内网,部署在客户自有服务器 / 算力集群,一次性软件授权 + 年服务费;金融、军工、政务、央国企强制要求本地化,是 B 端高毛利核心业务。
3. 行业垂直微调定制
通用基座叠加行业专有数据二次训练,生成医疗问诊、法律合同、电力巡检、油气勘探、教育题库等垂直专用模型,按项目制收费。
4. C 端 ToC 付费会员
长上下文扩容、深度思考模式、专属生成算力、无广告高速响应,豆包、Kimi、GPT 均采用订阅制变现。
5. AI Agent 数字员工(2026 增长最快赛道)
批量生成客服 Agent、财务对账 Agent、招聘筛选 Agent、运维监控 Agent、采购跟单 Agent,按月 / 按席位订阅收费,替代重复性人力岗位。
六、行业核心痛点与致命短板
1. 技术固有缺陷
幻觉问题:无依据编造数据、案例、法条,高精密业务必须搭配 RAG 强检索约束;
上下文遗忘:超长对话前端信息丢失,依赖 SSM 架构与滑动窗口注意力优化;
可解释性弱:黑盒生成逻辑,金融风控、医疗诊断等高风险场景难以合规举证。
2. 商业规模不经济悖论
用户量越大、调用频次越高,算力 Token 成本越高,极易出现产品越普及亏损越多;行业解法:模型量化压缩、MoE 稀疏推理、端侧离线推理降低云端依赖。
3. 成本壁垒
基座单次预训练千万级起步,算力、高质量标注数据、顶尖算法人才三重门槛,中小团队无力从零训练大基座,只能基于开源基座微调二次开发。
4. 合规监管红线(国内强制约束)
1.上线前必须完成大模型备案、安全评估、算法备案,未备案不得提供公网服务;
2.禁止生成违法违规、色情暴力、虚假不实、危害意识形态内容;
3.用户个人信息必须脱敏,训练数据禁止抓取隐私涉密数据;
4.生成内容需可溯源留痕,支持内容审计与追溯核查。
5. 市场格局内卷
百模大战彻底出清,第三梯队无生态无场景小模型逐步被并购或关停;行业从比拼参数大小转向比拼落地交付能力、行业解决方案、算力效率。
七、端侧大模型:手机 / PC / 硬件离线 AI
2026 年手机端侧 10B 参数模型成为标配,无需联网即可本地完成总结、翻译、文案、图片识别、语音助手,完全不上传用户数据,隐私性极强。
代表:小米端侧 MiMo、苹果 On-Device AI、华为盘古手机小模型,硬件 NPU 专门优化大模型推理速度。
八、未来三年(2026-2028)确定性演进路线
短期(1 年内)
1.Agent 智能体全面嵌入企业 OA、CRM、ERP 系统,流程自动化渗透率大幅提升;
2.开源模型性能追平闭源头部,私有化部署成本下降 60%;
3.多模型互联标准出台,不同厂商大模型可互相调用、协同分工。
中期(2 年)
世界模型规模化商用:AI 学习物理世界规则,用于机器人控制、自动驾驶仿真、工业产线数字孪生预判故障;
具身智能人形机器人绑定专属大模型,完成工厂分拣、仓储搬运、高危巡检。
长期(3 年)
1.大模型从 “生成式 AI” 升级为自主进化系统,可自主搜集合规数据迭代自身能力;
2.存算一体芯片普及,算力功耗大幅下降,智算中心 PUE 逼近 1.2 以下;
3.天地一体算力网络,卫星链路辅助偏远节点大模型调度,算力如同水电一样公共基础设施化。
九、企业落地选型极简建议
1.初创无技术团队:直接接入公有云 API(豆包 / 通义 / DeepSeek),最快 7 天上线 AI 功能;
2.有私有文档知识库:优先 RAG 向量库 + 公有基座,成本最低、见效最快;
3.国企 / 涉密单位:必须做本地化私有化部署,优先选择已完成备案的大厂基座;
4.硬件 IoT / 移动端产品:选用轻量化开源小模型做端侧离线推理,规避云端持续计费。
-
 LLM大语言模型典型案例分析|落地实战复盘
概述:本文聚焦2025-2026年已商业化落地、具备真实数据、可复用落地逻辑的四大LLM标杆案例,覆盖金融风控、工业智造、在线教育、智能客服四大核心赛道。统一采用「项目痛点→技术架构→落地流程→落地成效→现存问题→...
-
 LLM大语言模型落地案例分析报告—以家用智能座舱系统为例
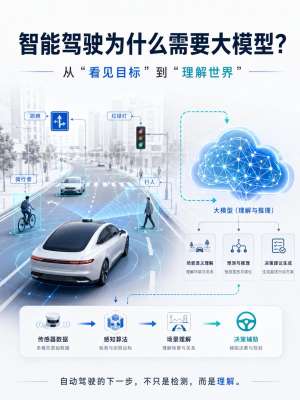
一、案例概述随着生成式人工智能技术快速迭代,LLM大语言模型已从通用对话场景,深度下沉至车载智能座舱垂直领域。传统车机语音系统多为固定指令匹配、语义理解僵化、交互生硬,无法满足家庭多成员...
-
 LLM大模型工具推荐2026完整版|全场景选型指南
2026 LLM选型核心标准:不再只看对话流畅度,重点看长文本理解、真实知识库RAG、多模态质量、Agent智能体能力、国产化合规、稳定输出。以下为目前全网综合体验最强、落地最稳、适配各行各业的主流LLM工具,分场景精准...
-
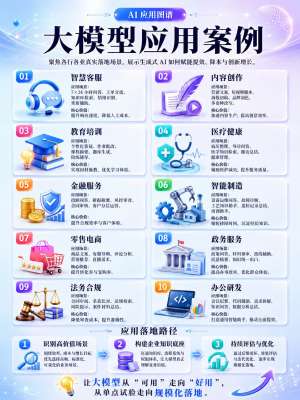 LLM大模型全行业应用场景(2026完整版|落地可用)
本文整理通用+政企+产业+ToB+ToC+车端+教育+医疗+文旅+开发运维全维度LLM落地场景,全部为当前可商业化、可项目落地的真实场景,无概念虚标,适合项目申报、方案撰写、产品规划、赛道调研使用。一、通用基础能力场景...
-
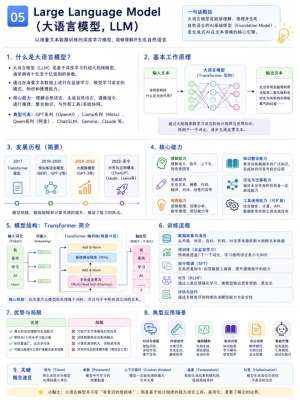 LLM大语言模型深度解析|2026完整版全解
核心前言:2026年是大语言模型从通用对话工具彻底转向产业智能底座、Agent自主生产力的关键拐点。行业认知已全面升级:LLM不再是“会聊天的AI”,而是基于海量数据概率学习、具备语义理解、逻辑推理、工具调用、自主规划、...
-
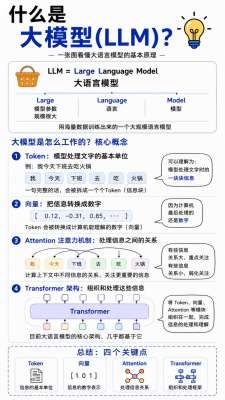 LLM大模型落地最佳实践|全指南
前言:大模型(LLM)已经从“技术demo”进入工业化、工程化、业务化落地阶段。绝大多数企业落地失败,并非模型能力不足,而是缺少标准化落地范式、Prompt混乱、向量库滥用、微调无策略、推理成本失控、幻觉风险未治理。本文总结行业...