LLM大模型常见问题详解|入门必懂、误区全解、核心科普
LLM大模型常见问题详解|入门必懂、误区全解、核心科普
前言:LLM(大语言模型)是当前人工智能的核心基础技术,多数人对大模型存在概念模糊、能力神化、认知误区、原理不懂等问题。本文汇总全网最高频、最核心、最易错的LLM常见问题,以问答形式通俗拆解,零基础可看懂,适合学习总结、作业科普、面试备考、行业认知。
一、基础概念类问题(入门必学)
Q1:什么是LLM大语言模型?
LLM(Large Language Model)即大语言模型,是基于海量文本数据训练、超大参数规模的生成式人工智能模型。核心能力是理解人类自然语言、逻辑推理、内容生成、知识问答、文本创作,是AIGC、智能对话、AI办公、智能助手的底层核心。区别于传统AI,LLM具备通用理解、泛化能力、自主生成三大特征。
Q2:大模型和传统AI有什么区别?
传统AI属于规则式、单任务AI,只能做预设指令内的工作,无法举一反三、无法自主生成内容;LLM属于通用生成式AI,无需单独编程预设,通过海量学习形成通用能力,可适配万千场景、自主理解语义、自由生成内容、完成复杂逻辑任务。
Q3:参数规模越大,模型一定越强吗?
不一定。早期大模型靠“堆参数”提升能力,2026年行业进入精训时代。模型能力取决于数据质量、训练算法、对齐技术、推理优化、微调策略。小参数精调模型,往往比大参数粗训模型效果更好、速度更快、成本更低。参数不代表一切,算力、数据、算法、对齐四大维度共同决定模型上限。
Q4:什么是预训练、微调、对齐?
预训练:模型在海量公开文本中学习语法、知识、逻辑、语言规律,搭建基础认知能力;
微调:针对特定行业、特定场景数据二次训练,让模型适配专属业务;
对齐(RLHF):通过人类反馈强化学习,让模型输出安全、合规、有用、真实的内容,杜绝胡说、偏见、有害输出。
二、能力原理类问题(核心难点)
Q5:LLM为什么能听懂人话、自动生成内容?
LLM的核心原理是概率预测。模型通过海量学习,掌握语言逻辑、知识关联、上下文关系,每一次输出都是根据上文内容,逐字预测下一个最高概率的文字,连贯形成通顺、合理的回答。模型不是“真的理解”,而是通过海量数据拟合出超强的语言生成与逻辑推理能力。
Q6:大模型有真正的“思维和意识”吗?
没有。目前所有LLM均为统计拟合、概率生成,无自我意识、无主观思维、无情感认知、无真实理解能力。看似智能的回答,本质是数据规律的组合输出,并非真正“听懂、思考、明白”。
Q7:什么是上下文窗口?有什么作用?
上下文窗口是大模型单次对话能记住的最大文本长度。窗口越大,能记忆的对话内容、文档内容越长,长文本问答、长文章创作、长代码解析能力越强。窗口过小,会出现“记不住前文、对话断层、逻辑断裂”的问题。
Q8:大模型的涌现能力是什么?
当模型参数、数据量达到一定阈值后,模型会突然具备小模型不具备的高阶能力,包括逻辑推理、数学计算、代码编写、复杂创作、多步骤解题等,这种质变现象称为涌现能力,是大模型区别于小模型的核心特征。
三、缺陷与局限类问题(高频考点)
Q9:什么是AI幻觉?为什么会胡说八道?
AI幻觉是LLM最核心缺陷,指模型凭空编造事实、编造数据、编造案例、编造文献,输出看似通顺、实则虚假错误的内容。成因:模型只基于概率生成,不具备事实判断能力,在知识盲区、模糊问题下容易自主“补全内容”,出现虚假输出。
Q10:大模型为什么会知识过时?
LLM的知识截止于训练数据截止时间,无法自主实时联网更新。训练完成后产生的新事件、新数据、新政策、新知识,模型完全未知,会出现知识滞后、回答失效、信息老旧等问题。联网搜索、实时增量训练可缓解,但无法彻底根治。
Q11:大模型存在哪些天然短板?
1. 无真实理解与意识,只会概率生成;
2. 易产生AI幻觉,编造虚假信息;
3. 知识存在时间壁垒,无法自主实时更新;
4. 数学、精密逻辑、精准计算易出错;
5. 容易受提示词误导,产生偏见输出;
6. 上下文有限,超长逻辑易混乱断层。
Q12:温度值(Temperature)是什么?有什么用?
温度值控制模型随机性与创造性。数值越低,输出越稳定、精准、重复,适合答题、办公、专业写作;数值越高,输出越发散、创意、多变,适合文案创作、脑洞设计、灵感拓展。日常专业使用建议调低温度,创意使用可调高温度。
四、应用与落地类问题
Q13:LLM主流应用场景有哪些?
覆盖全行业通用场景:智能对话问答、文案写作、代码生成、数据分析、总结翻译、课件制作、办公辅助、客服机器人、行业知识库、智能咨询、内容创作、逻辑推理、试题解析、方案撰写等。
Q14:什么是RAG检索增强生成?解决什么问题?
RAG是大模型落地企业、行业的核心技术。通过实时检索私有知识库、行业文档,让模型基于真实资料回答,有效解决AI幻觉、知识过时、行业不懂、数据不准四大痛点,是目前企业大模型落地的主流方案。
Q15:什么是提示词工程(Prompt)?
提示词工程是通过精准、规范、结构化提问,引导大模型输出高质量、符合需求的内容。相同模型,不同提示词,输出效果差距极大。清晰的角色、场景、要求、格式、细节约束,是高质量AI输出的关键。
五、安全与伦理类问题
Q16:LLM存在哪些安全风险?
主要包含:幻觉虚假信息风险、隐私泄露风险、恶意提问诱导、偏见歧视输出、不良内容生成、知识误导、数据盗用、Prompt注入攻击等。因此大模型必须经过安全对齐与内容审核才能商用。
Q17:为什么大模型会拒绝部分问题?
大模型经过安全对齐训练,内置安全风控规则,对于违法、违规、低俗、侵权、涉密、危险、不良引导类问题,会自动拦截拒绝,目的是保障输出合规、规避风险、坚守伦理底线。
六、行业认知与误区(高频避坑)
Q18:大模型可以完全替代人类工作吗?
不能。LLM擅长整合、生成、总结、复刻、辅助,但无法替代人类的创新思维、价值判断、情感共情、复杂决策、原创突破、责任承担。未来趋势是人+AI协同,AI替代重复劳动,人类专注高阶创造与决策。
Q19:模型越大、越新,回答一定越准吗?
不是。新版模型侧重安全、合规、通用能力提升,部分场景下老模型精准度、自由度反而更高。专业场景下,垂直微调小模型 + RAG知识库,往往优于通用超大模型。
Q20:LLM和AIGC、人工智能是什么关系?
人工智能(AI)是总称;LLM大模型是AI的核心底座;AIGC是基于大模型的生成式应用结果。简单理解:AI是整体,LLM是核心引擎,AIGC是产出内容。
七、总结:LLM核心认知
LLM大语言模型是当前人工智能最核心的通用技术,优势是语言理解、内容生成、逻辑推理、高效辅助,天然短板是无真实认知、易幻觉、知识滞后、精准度有限。正确使用大模型的核心逻辑:把AI当辅助工具,不盲从、不依赖、善利用、勤校验,实现人机高效协同。
-
 LLM大语言模型典型案例分析|落地实战复盘
概述:本文聚焦2025-2026年已商业化落地、具备真实数据、可复用落地逻辑的四大LLM标杆案例,覆盖金融风控、工业智造、在线教育、智能客服四大核心赛道。统一采用「项目痛点→技术架构→落地流程→落地成效→现存问题→...
-
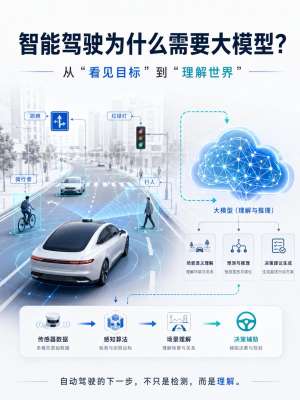 LLM大语言模型落地案例分析报告—以家用智能座舱系统为例
一、案例概述随着生成式人工智能技术快速迭代,LLM大语言模型已从通用对话场景,深度下沉至车载智能座舱垂直领域。传统车机语音系统多为固定指令匹配、语义理解僵化、交互生硬,无法满足家庭多成员...
-
 LLM大模型工具推荐2026完整版|全场景选型指南
2026 LLM选型核心标准:不再只看对话流畅度,重点看长文本理解、真实知识库RAG、多模态质量、Agent智能体能力、国产化合规、稳定输出。以下为目前全网综合体验最强、落地最稳、适配各行各业的主流LLM工具,分场景精准...
-
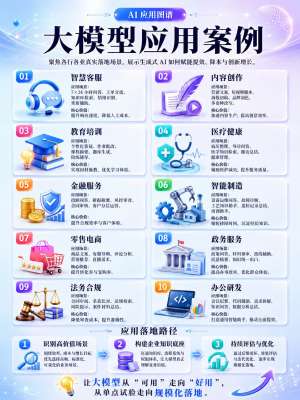 LLM大模型全行业应用场景(2026完整版|落地可用)
本文整理通用+政企+产业+ToB+ToC+车端+教育+医疗+文旅+开发运维全维度LLM落地场景,全部为当前可商业化、可项目落地的真实场景,无概念虚标,适合项目申报、方案撰写、产品规划、赛道调研使用。一、通用基础能力场景...
-
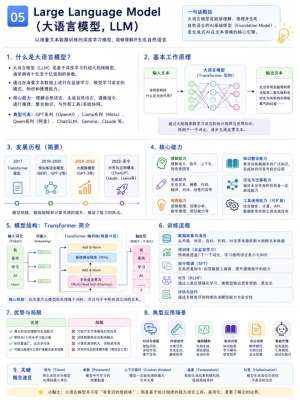 LLM大语言模型深度解析|2026完整版全解
核心前言:2026年是大语言模型从通用对话工具彻底转向产业智能底座、Agent自主生产力的关键拐点。行业认知已全面升级:LLM不再是“会聊天的AI”,而是基于海量数据概率学习、具备语义理解、逻辑推理、工具调用、自主规划、...
-
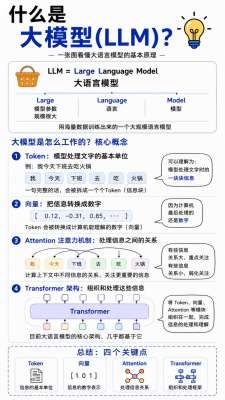 LLM大模型落地最佳实践|全指南
前言:大模型(LLM)已经从“技术demo”进入工业化、工程化、业务化落地阶段。绝大多数企业落地失败,并非模型能力不足,而是缺少标准化落地范式、Prompt混乱、向量库滥用、微调无策略、推理成本失控、幻觉风险未治理。本文总结行业...