LLM大模型常见问题FAQ(全网高频问题通俗详解)
LLM大模型常见问题FAQ(全网高频问题通俗详解)
说明:本文汇总学习、面试、开发、落地中最高频的LLM大模型常见问题,摒弃晦涩公式,用通俗、精准、可落地的方式解答,适合新手学习、技术答疑、职场面试、项目复盘。
一、基础认知类问题
Q1:什么是LLM大语言模型?
A:LLM(Large Language Model)是基于海量文本数据训练的生成式人工智能大模型,核心能力是理解人类自然语言、逻辑推理、知识问答、内容生成、总结改写、代码编写。它不是简单检索答案,而是通过概率预测逐字生成内容。
Q2:大模型和传统小模型、传统AI有什么区别?
A:传统AI是规则式/检索式,只能执行固定指令、识别固定内容;小模型只能做单一任务。LLM大模型是通用生成式,具备泛化能力,一个模型可胜任百种任务,支持零样本、少样本、自主推理。
Q3:参数规模越大,模型一定越强吗?
A:不一定。参数只是基础,数据质量、训练方式、对齐技术、微调策略更关键。存在很多大参数“笨模型”和小参数“精模型”,2026行业趋势是小精模型+垂直微调,而非盲目堆参数。
Q4:基座大模型和对话模型有什么区别?
A:基座模型(Base Model)只具备原始语言能力,不会聊天、不懂人设、不懂规则;对话模型(Chat Model)经过SFT监督微调、RLHF人类对齐,更听话、更安全、更适配人机交互,是我们日常使用的版本。
二、核心原理类问题
Q5:大模型是怎么思考、怎么生成答案的?
A:大模型没有“意识”和“思维”,核心逻辑是概率逐字预测。根据上文语境,计算下一个字出现的概率,选取最高概率词汇持续输出,形成完整语句,依靠海量数据学习语言逻辑、知识、语法、推理规律。
三、幻觉与准确性问题(最高频)
Q9:什么是大模型幻觉?为什么会出现幻觉?
A:幻觉指模型一本正经编造虚假事实、数据、案例、文献。成因:训练数据冲突、概率生成机制无事实校验、上下文信息不足、参数推理偏差、知识时效性缺失。模型只会“通顺生成”,不会“判断真假”。
Q10:怎么解决大模型幻觉问题?
A:1、接入RAG检索增强,让模型基于真实资料回答;2、开启实时联网;3、prompt约束事实输出;4、垂直领域微调;5、输出后事实校验;6、降低随机性参数。
Q11:大模型为什么有时候答非所问、逻辑混乱?
A:常见原因:prompt指令模糊、上下文溢出、温度值过高太发散、模型适配场景不足、输入信息缺失、多轮对话记忆混乱。
四、参数设置与调用问题
Q12:Temperature温度值是什么?怎么设置?
A:控制模型随机性和创造性。数值0-1: 0:极致严谨、固定输出、适合问答、数据、公文; 0.3-0.7:均衡通用、日常对话、文案; 0.8-1:高创意、发散、适合写作、脑洞创作。
Q13:Top_P、Top_K参数作用是什么?
A:都是采样筛选参数,用于控制输出多样性。Top_P控制候选词概率区间,Top_K控制候选词数量,主要用于平衡稳定性与创造性,企业落地中常配合温度值使用。
Q14:大模型为什么会重复话术、循环语句?
A:上下文冗余、参数设置过稳、输入指令重复、模型收敛性不足。解决:清空上下文、调低温度、精简prompt、增加禁止重复参数。
五、微调、RAG、提示词工程问题
Q15:RAG和微调有什么区别?该怎么选?
A:RAG(检索增强):实时读取外部知识库,不改模型权重,低成本、快落地、适合实时知识、企业资料问答;
微调(Fine-tune):修改模型参数,让模型固化专属能力,适合固定场景、固定话术、垂直行业标准化输出。短期更新知识用RAG,长期固化能力用微调。
Q16:什么是Prompt工程?为什么重要?
A:通过标准化、结构化指令,引导模型输出精准结果。好的Prompt可以大幅降低幻觉、提升准确率,是最低成本提升AI效果的方式。
Q17:零样本、少样本、思维链CoT是什么?
A:零样本:不给案例直接回答;少样本:给少量示范案例;CoT思维链:引导模型分步推理、逐步拆解,大幅提升数学、逻辑、推理类问题准确率。
六、训练、推理与部署问题
Q18:预训练、SFT、RLHF分别是什么?
A:预训练:海量通用数据学习语言与基础知识; SFT监督微调:让模型学会按照人类指令输出; RLHF人类反馈强化学习:让模型更安全、更合规、更贴合人类偏好。
Q19:本地部署和API调用有什么区别?
A:API调用:联网调用云端模型、低成本、无需显卡、依赖网络;本地部署:私有化部署、数据不出内网、响应更快、隐私性高、需要GPU算力。
Q20:推理速度慢是什么原因?
A:模型参数过大、显存不足、上下文过长、批量请求拥堵、硬件算力偏低、网络延迟高。
七、知识时效与更新问题
Q21:大模型知识为什么有截止时间?
A:大模型的知识全部来自训练数据集,训练结束后不再自动学习新内容,因此存在知识断层,无法识别最新事件、最新政策、最新数据。
Q22:如何让大模型学会最新知识?
A:三种方式:1、开启联网搜索;2、接入RAG实时知识库;3、增量训练/微调模型。
八、安全、合规与局限性问题
Q23:大模型有哪些安全风险?
A:幻觉误导、隐私泄露、prompt注入、恶意诱导、违规内容生成、数据投毒、偏见歧视、信息滞后。
Q24:什么是Prompt注入攻击?
A:用户通过特殊指令绕过安全屏障、覆盖原有系统提示词,诱导模型输出违规内容、泄露配置、越权执行任务,是LLM落地主要安全隐患之一。
Q25:LLM真正的短板是什么?
A:无真实认知、无记忆自主学习能力、容易产生幻觉、不擅长精准数学计算、无法百分百保证事实正确、依赖数据质量、长逻辑推理容易出错。
九、行业落地高频问题
Q26:企业做AI落地,优先选RAG还是微调?
A:90%企业优先RAG,成本低、上线快、可随时更新知识库、无需大量标注数据;只有标准化、高频固定场景、需要深度适配模型能力时,才用微调。
Q27:小模型能不能替代大模型?
A:通用推理、复杂创作、深度逻辑依然是大模型优势;垂直落地场景、轻量化部署、高频简单任务,优质小模型完全可以平替大模型,且速度更快、成本更低。
Q28:多轮对话为什么越聊越不准?
A:多轮对话上下文累积冗余信息、噪声叠加、记忆偏移、上下文窗口临近溢出,导致模型理解偏差、逻辑错乱。解决:定期清空上下文、精简对话、分段总结。
-
 LLM大语言模型典型案例分析|落地实战复盘
概述:本文聚焦2025-2026年已商业化落地、具备真实数据、可复用落地逻辑的四大LLM标杆案例,覆盖金融风控、工业智造、在线教育、智能客服四大核心赛道。统一采用「项目痛点→技术架构→落地流程→落地成效→现存问题→...
-
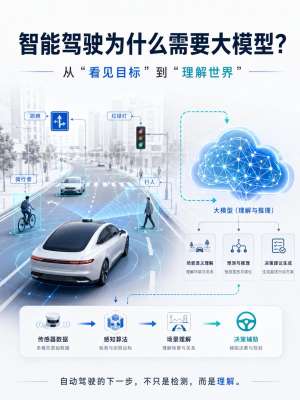 LLM大语言模型落地案例分析报告—以家用智能座舱系统为例
一、案例概述随着生成式人工智能技术快速迭代,LLM大语言模型已从通用对话场景,深度下沉至车载智能座舱垂直领域。传统车机语音系统多为固定指令匹配、语义理解僵化、交互生硬,无法满足家庭多成员...
-
 LLM大模型工具推荐2026完整版|全场景选型指南
2026 LLM选型核心标准:不再只看对话流畅度,重点看长文本理解、真实知识库RAG、多模态质量、Agent智能体能力、国产化合规、稳定输出。以下为目前全网综合体验最强、落地最稳、适配各行各业的主流LLM工具,分场景精准...
-
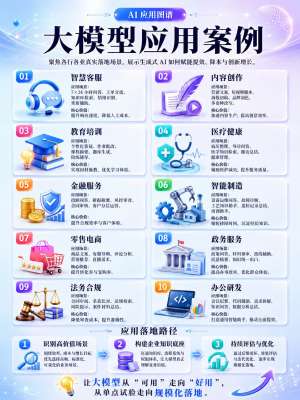 LLM大模型全行业应用场景(2026完整版|落地可用)
本文整理通用+政企+产业+ToB+ToC+车端+教育+医疗+文旅+开发运维全维度LLM落地场景,全部为当前可商业化、可项目落地的真实场景,无概念虚标,适合项目申报、方案撰写、产品规划、赛道调研使用。一、通用基础能力场景...
-
 LLM大语言模型深度解析|2026完整版全解
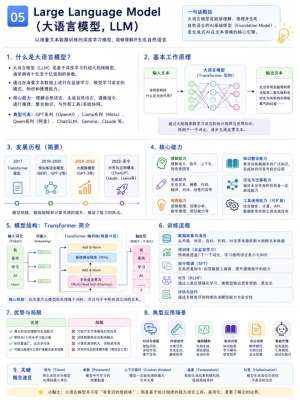
核心前言:2026年是大语言模型从通用对话工具彻底转向产业智能底座、Agent自主生产力的关键拐点。行业认知已全面升级:LLM不再是“会聊天的AI”,而是基于海量数据概率学习、具备语义理解、逻辑推理、工具调用、自主规划、...
-
 LLM大模型落地最佳实践|全指南
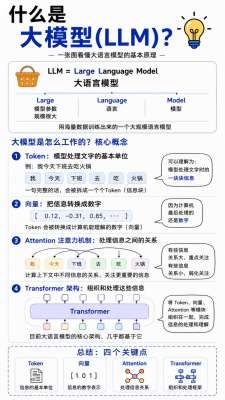
前言:大模型(LLM)已经从“技术demo”进入工业化、工程化、业务化落地阶段。绝大多数企业落地失败,并非模型能力不足,而是缺少标准化落地范式、Prompt混乱、向量库滥用、微调无策略、推理成本失控、幻觉风险未治理。本文总结行业...