LLM大语言模型全面指南|(2026完整版)
LLM大语言模型全面指南|(2026完整版)
前言:LLM(大语言模型,Large Language Model)是当前人工智能的核心底座,所有AIGC、智能问答、AI
Agent、企业知识库、智能客服均基于LLM实现。本指南为从零到落地的全栈通识手册,无废话、全体系、可直接用于学习、面试、项目开发、企业落地。
一、LLM核心定义(通俗精准)
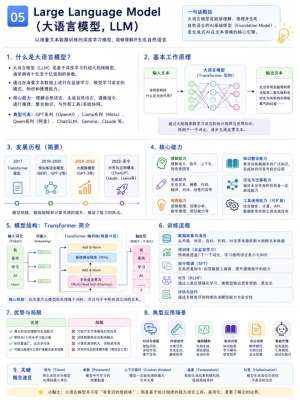
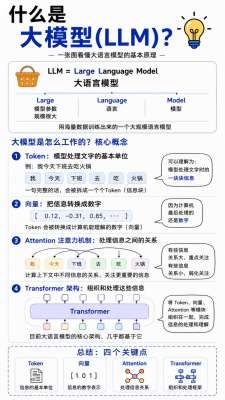
LLM是基于Transformer架构、依托海量文本数据训练的大规模生成式AI模型。本质是一个超高维概率预测机器,通过学习人类语言规律、知识逻辑、语法语义、思维范式,实现理解文本、生成文本、逻辑推理、知识问答、任务执行。
核心特征:大参数、大数据、强泛化、上下文理解、自回归生成。
二、LLM与传统AI的本质区别
1、传统小模型:单任务专属,只能做分类、识别、匹配,不懂语义,无法通用,需要大量标注数据。
2、LLM大模型:通用人工智能底座,一个模型解决所有语言类任务,无需大量专项标注,具备泛化、推理、联想、创作、总结、逻辑推演能力。
三、LLM底层核心原理(极简吃透)
1、Token分词机制
模型不认识文字,只认识Token(字词片段)。输入文本会被拆分为最小语义单元,转为向量输入模型,是所有LLM运行的基础。中英文、符号、数字统一编码处理。
2、自回归生成(核心逻辑)
LLM不会一次性写完答案,采用逐字预测、逐词生成的模式:输入上下文→预测下一个概率最高Token→拼接回上下文→继续预测,直到生成结束符或达到最大长度。这也是AI回答连贯、逐步输出的根本原因。
3、上下文窗口Context Window
模型能记住的最大对话/文本长度。窗口越大,长文本理解、长对话记忆、长文档总结能力越强,是2026大模型核心升级方向。
2、Encoder-only 纯编码架构(理解类)
代表:BERT。主打文本理解、分类、情感分析、语义匹配,不擅长生成内容,多用于传统NLP任务。
3、Encoder-Decoder 编解码架构(转换类)
代表:T5、Bart。主打文本转换任务:翻译、摘要、改写、润色,擅长输入输出结构化对应转换。
五、LLM完整训练生命周期(行业标准四阶段)
1、预训练 Pre-training(筑基)
使用万亿级无标注通用文本做自监督学习,让模型学习语法、常识、世界知识、语言逻辑。决定模型的基础智商、通识能力、语言流畅度。成本最高、数据量最大、周期最长。
2、监督微调 SFT(对齐任务)
使用高质量人工标注对话、指令数据微调,让模型学会按照人类指令执行任务,告别随机生成,适配问答、创作、办公等真实场景。
3、人类反馈强化学习 RLHF(对齐价值观)
通过人类打分、AI奖励模型,筛选优质回答,强化正向输出,抑制有害、错误、混乱内容,让模型更安全、更贴合人类偏好、更精准。
4、后训练迭代(持续优化)
持续增量数据训练、领域微调、安全对齐、能力迭代,适配行业场景与最新知识。
六、LLM核心能力矩阵(通用能力全覆盖)
1、基础语言能力:分词理解、语法纠错、文本润色、翻译、摘要、改写、扩写、分类、标签提取。
2、知识问答能力:通识问答、专业知识解答、百科解读、行业知识输出。
3、逻辑推理能力:数理推理、代码逻辑、因果分析、方案推演、问题拆解。
4、创作生成能力:文案、公文、脚本、小说、报告、代码、方案、话术生成。
5、工具调用能力:联网搜索、代码解释器、函数调用、第三方API对接、AI Agent任务拆解。
6、记忆与对话能力:多轮对话记忆、上下文承接、角色人设稳定、长文本交互。
七、LLM企业落地四大核心方案(2026主流)
1、Prompt工程(零成本最快落地)
不改动模型参数,通过精准提示词、角色设定、格式约束、思维链引导,大幅提升输出质量,适合轻量化场景、办公提效、通用问答。
2、RAG检索增强生成(企业知识库首选)
解决大模型知识滞后、幻觉、不懂企业私有数据问题。将企业文档、资料、知识库向量化检索,实时投喂给模型,实现私有知识精准问答,是目前企业落地最主流、性价比最高的方案。
3、微调 Fine-tuning(行业专属模型)
用行业专属数据微调模型参数,让模型深度适配垂直领域(物业、教育、医疗、法律、政务、电商),形成行业专属话术、知识、逻辑,适合标准化高频行业场景。
4、AI Agent智能体(高阶自动化)
基于LLM做任务拆解、规划、工具调用、自主迭代、闭环执行,实现自动办公、自动复盘、自动调研、自动运营,是2026AI落地升级核心方向。
八、主流LLM模型梯队(2026最新排行)
1、国际顶级模型
GPT-4o、Claude 3.5、Gemini Ultra:综合能力最强、多模态顶尖、推理能力顶级,适合复杂任务、科研、高端创作。
2、国内头部闭源模型
文心一言4.0、通义千问、讯飞星火、智谱清言:中文理解强、合规性高、本地化服务稳定,适合国内企业商用落地。
3、开源可部署模型(私有化首选)
Qwen、LLaMA3、Mistral、Llama2、DeepSeek:支持本地部署、私有化部署、二次微调、无接口费用,适合数据涉密、自主可控企业。
九、LLM核心局限与痛点(必懂避坑)
1、幻觉问题:会编造不存在数据、案例、文献,看似通顺实则错误,是LLM最大硬伤。
2、知识时效性滞后:预训练数据有时间截止,无法自动获取最新实时资讯。
3、上下文限制:超长文本容易遗忘、错位、丢失细节。
4、数理与严谨性不足:复杂计算、精密逻辑、专业数据容易出错。
5、无真实认知与意识:只是概率拟合,不理解语义本质,无法自主产生思维。
十、LLM行业全域应用场景(全覆盖)
办公提效:公文写作、报告生成、会议纪要、邮件润色、数据分析、PPT大纲。
企业服务:智能客服、知识库问答、员工培训、流程答疑、售后话术生成。
内容产业:文案、短视频脚本、直播话术、自媒体创作、图文生成。
政企政务:政策解读、公文处理、信访答疑、资料整编、合规自查。
技术开发:代码生成、BUG排查、脚本编写、接口文档、技术答疑。
垂直行业:医疗问诊辅助、法律文书、教育答疑、物业智能问答、金融分析。
十一、2026 LLM最新发展趋势
1、轻量化私有化普及:小参数高性能模型成为企业部署主流,低成本、高可控。
2、RAG+微调融合落地:检索补知识、微调塑风格,成为行业模型标准方案。
3、多模态大一统:文本、图片、音频、视频、代码统一理解生成。
4、AI Agent自动化爆发:从“问答工具”升级为“自主执行工作的智能员工”。
5、行业垂直模型精细化:通用模型逐步饱和,垂直专业模型价值持续提升。
6、安全对齐与合规标准化:内容安全、数据安全、隐私合规成为企业落地硬性标准。
十二、LLM核心总结(一句话吃透全局)
LLM是基于Transformer的通用语言概率生成模型,通过预训练习得通识能力,通过SFT/RLHF对齐人类需求,通过RAG/微调适配企业私有场景,是当前人工智能产业的底层操作系统,未来所有数字化、智能化应用,都将基于LLM重构。
-
 LLM大语言模型典型案例分析|落地实战复盘
概述:本文聚焦2025-2026年已商业化落地、具备真实数据、可复用落地逻辑的四大LLM标杆案例,覆盖金融风控、工业智造、在线教育、智能客服四大核心赛道。统一采用「项目痛点→技术架构→落地流程→落地成效→现存问题→...
-
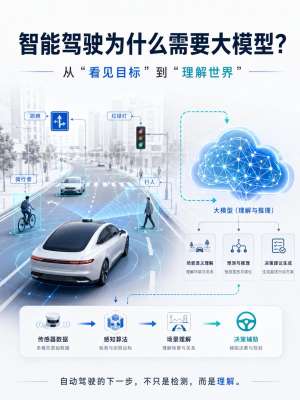 LLM大语言模型落地案例分析报告—以家用智能座舱系统为例
一、案例概述随着生成式人工智能技术快速迭代,LLM大语言模型已从通用对话场景,深度下沉至车载智能座舱垂直领域。传统车机语音系统多为固定指令匹配、语义理解僵化、交互生硬,无法满足家庭多成员...
-
 LLM大模型工具推荐2026完整版|全场景选型指南
2026 LLM选型核心标准:不再只看对话流畅度,重点看长文本理解、真实知识库RAG、多模态质量、Agent智能体能力、国产化合规、稳定输出。以下为目前全网综合体验最强、落地最稳、适配各行各业的主流LLM工具,分场景精准...
-
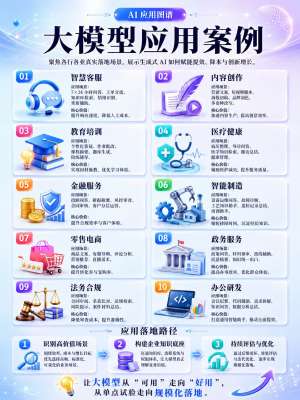 LLM大模型全行业应用场景(2026完整版|落地可用)
本文整理通用+政企+产业+ToB+ToC+车端+教育+医疗+文旅+开发运维全维度LLM落地场景,全部为当前可商业化、可项目落地的真实场景,无概念虚标,适合项目申报、方案撰写、产品规划、赛道调研使用。一、通用基础能力场景...
-
 LLM大语言模型深度解析|2026完整版全解
核心前言:2026年是大语言模型从通用对话工具彻底转向产业智能底座、Agent自主生产力的关键拐点。行业认知已全面升级:LLM不再是“会聊天的AI”,而是基于海量数据概率学习、具备语义理解、逻辑推理、工具调用、自主规划、...
-
 LLM大模型落地最佳实践|全指南
前言:大模型(LLM)已经从“技术demo”进入工业化、工程化、业务化落地阶段。绝大多数企业落地失败,并非模型能力不足,而是缺少标准化落地范式、Prompt混乱、向量库滥用、微调无策略、推理成本失控、幻觉风险未治理。本文总结行业...