LLM最佳实践|提示词、工程落地、评估与安全全流程指南
LLM最佳实践|提示词、工程落地、评估与安全全流程指南
核心总纲:大语言模型(LLM)不是万能黑盒,落地的核心是合理设定边界、做好提示工程、管控输入输出、持续迭代评估、守住内容安全。无论是个人使用、业务原型开发,还是企业生产级部署,都可以遵循这套标准化最佳实践,减少幻觉、提升输出稳定性、降低风险。
一、提示词工程最佳实践(Prompt)
1. 清晰定义角色、任务、输出格式
不要只提模糊需求,一次性告知模型身份、目标、约束条件。差示例:帮我写方案。好示例:你是跨境物流顾问,撰写一份300字以内的物流成本控本方案,分3点,纯文本无列表符号。
2. 拆分复杂任务,分步思考
长任务不要一次性丢给模型。采用思维链(CoT),要求模型先列出思考过程,再给出结论;多步骤业务,分多轮对话依次执行,降低逻辑错误与幻觉概率。
3. 提供参考上下文,减少凭空编造
需要模型基于特定文档回答时,把原文片段附在prompt内,或接入RAG检索增强;明确限定“仅使用提供资料作答,资料没有就直接说明无法回答,禁止编造信息”。
4. 设置边界约束,禁止过度发挥
明确字数、风格、禁止内容。例如:不编造人名、数据、法规条文;不确定信息直接标注,不做主观猜测。
5. 少量样本Few-shot提升一致性
输出格式固定场景,附上1~3组输入输出样例,模型更容易对齐格式、语气,适合分类、抽取、结构化输出场景。
二、RAG检索增强最佳实践
RAG是抑制幻觉最有效的方案,核心要点:
1. 文档预处理:清洗冗余内容,按语义切块,块长不宜过大;增加摘要、元数据(来源、时间、文档名称)方便溯源。
2. 检索策略:混合检索,向量检索+关键词检索结合,提升召回准确率;设置召回数量上限,过滤低相关片段。
3. 引用溯源:要求模型回答中标注信息来源段落,方便人工核验。
4. 边界控制:检索无匹配资料时,禁止模型编造答案。
三、模型选型与调用最佳实践
1. 任务分级选型:简单分类、摘要用轻量低成本模型;复杂推理、长文档、专业领域任务选用大参数量高阶模型。不要全部场景无脑使用最贵模型,控制成本。
2. 长上下文管理:超长文档优先RAG,不要一次性塞满上下文窗口;定期清理无用对话历史,避免上下文污染。
3. 调用策略:增加重试、超时熔断、限流机制;生产环境增加缓存,重复查询直接返回缓存结果,节省token与接口费用。
4. 温度参数调优:事实类任务temperature调低(0~0.3),减少随机性;创意写作、头脑风暴调高(0.7~1.0)。
四、输出评估与迭代最佳实践
不能只靠人工主观感受判断效果,建立评估集持续迭代:
1. 构建测试数据集:覆盖正常样例、边界样例、恶意样例。
2. 评估指标:事实准确率、幻觉率、格式合规率、相关性、安全通过率。
3. 评估方式:自动指标初筛 + 人工抽样复核;线上埋点收集用户负反馈,持续优化提示词、知识库。
五、生产环境安全与风控最佳实践
1. 输入侧防护:Prompt注入检测,拦截试图篡改角色、绕过规则的攻击指令;过滤敏感个人信息,做隐私脱敏。
2. 输出侧审核:内容安全过滤器,识别违法、暴力、歧视、虚假营销内容;重要业务场景,高危输出强制人工复核。
3. 数据管控:禁止把用户机密、核心业务原始数据直接输入公共大模型;区分公有模型、私有化部署模型的数据权限。
4. 日志留存:保存调用日志、输入输出记录,用于问题排查与审计,遵守数据合规法规。
六、幻觉问题专项应对最佳实践
1. 明确指令:不知道就承认,禁止编造数据、文献、案例。
2. 引用溯源,所有结论绑定参考资料。
3. 事实类内容增加二次校验环节,关键数据对接外部工具(计算器、数据库、搜索引擎)。
4. 降低temperature,减少模型随机发挥。
七、Agent智能体开发最佳实践
1. 工具最小化:只开放必要工具,严格限制工具调用权限,防止越权操作。
2. 限制循环次数,设置最大迭代轮次,避免无限循环调用。
3. 每一步保留思考记录,方便调试定位出错环节。
八、常见避坑总结
1. 不要把LLM当成数据库,事实性内容必须核验。
2. 不要过度依赖单一prompt,业务上线前必须做测试集验证。
3. 不要一次性传入无清洗的海量原始文档,容易造成信息干扰。
4. 不要忽略prompt注入、数据泄露等安全风险。
5. 不要期望一次调优永久稳定,LLM需要持续监控迭代。
-
 LLM大语言模型典型案例分析|落地实战复盘
概述:本文聚焦2025-2026年已商业化落地、具备真实数据、可复用落地逻辑的四大LLM标杆案例,覆盖金融风控、工业智造、在线教育、智能客服四大核心赛道。统一采用「项目痛点→技术架构→落地流程→落地成效→现存问题→...
-
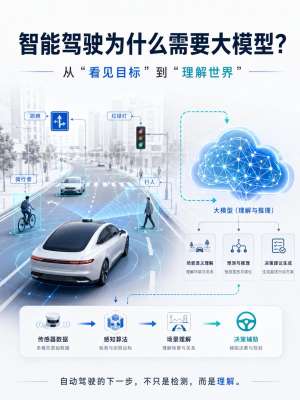 LLM大语言模型落地案例分析报告—以家用智能座舱系统为例
一、案例概述随着生成式人工智能技术快速迭代,LLM大语言模型已从通用对话场景,深度下沉至车载智能座舱垂直领域。传统车机语音系统多为固定指令匹配、语义理解僵化、交互生硬,无法满足家庭多成员...
-
 LLM大模型工具推荐2026完整版|全场景选型指南
2026 LLM选型核心标准:不再只看对话流畅度,重点看长文本理解、真实知识库RAG、多模态质量、Agent智能体能力、国产化合规、稳定输出。以下为目前全网综合体验最强、落地最稳、适配各行各业的主流LLM工具,分场景精准...
-
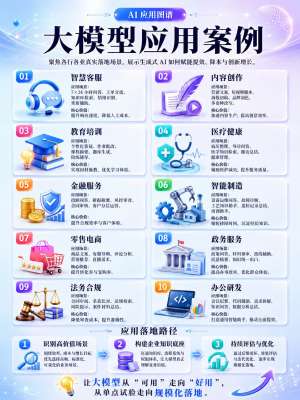 LLM大模型全行业应用场景(2026完整版|落地可用)
本文整理通用+政企+产业+ToB+ToC+车端+教育+医疗+文旅+开发运维全维度LLM落地场景,全部为当前可商业化、可项目落地的真实场景,无概念虚标,适合项目申报、方案撰写、产品规划、赛道调研使用。一、通用基础能力场景...
-
 LLM大语言模型深度解析|2026完整版全解
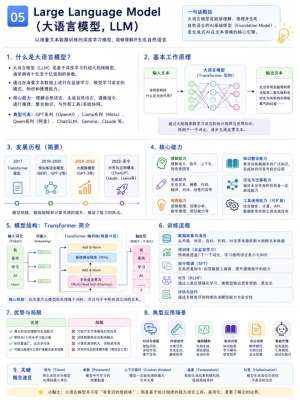
核心前言:2026年是大语言模型从通用对话工具彻底转向产业智能底座、Agent自主生产力的关键拐点。行业认知已全面升级:LLM不再是“会聊天的AI”,而是基于海量数据概率学习、具备语义理解、逻辑推理、工具调用、自主规划、...
-
 LLM大模型落地最佳实践|全指南
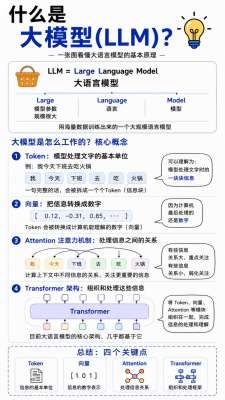
前言:大模型(LLM)已经从“技术demo”进入工业化、工程化、业务化落地阶段。绝大多数企业落地失败,并非模型能力不足,而是缺少标准化落地范式、Prompt混乱、向量库滥用、微调无策略、推理成本失控、幻觉风险未治理。本文总结行业...