LLM深度解析|模型原理、能力边界、落地场景、选型与风险管控
LLM深度解析|模型原理、能力边界、落地场景、选型与风险管控
前言:LLM(Large Language
Model,大语言模型)是以Transformer架构为基础、依托海量文本数据训练生成的深度学习模型,核心是学习人类语言的语法、语义、逻辑、知识与表达范式,实现文本理解、生成、推理、总结、翻译等能力。本解析从底层原理、核心能力、技术演进、企业落地场景、选型维度、成本测算、风险合规、未来趋势完整拆解,面向企业数字化项目、行业招商、技术选型、展会宣讲使用,兼顾技术人员与业务管理者阅读。
一、底层基础:LLM核心原理通俗解读
1. Transformer架构
Transformer的自注意力机制(Self-Attention)是LLM的基石,能够同时识别文本长距离关联,理解上下文词语之间的逻辑关系。模型没有真正“读懂”文字,而是基于海量数据学习词语出现的概率分布,预测下一个最合理的token(词元),逐字生成回答。
2. 训练三阶段
预训练:使用互联网海量文本、书籍、论文、网页原始数据做基础学习,建立通用知识和语言能力; SFT有监督微调:人工标注高质量问答数据,对齐输出格式,学会遵循指令; RLHF人类反馈强化学习:人类对模型回答打分,用反馈优化模型输出偏好,减少有害、虚假回答,对齐人类价值观。
3. Token词元机制
文本会被拆分为最小单元token,中文大约1个汉字≈2个token。上下文窗口代表模型一次性能够读取的最大token长度,窗口越大,可一次性处理的文档、合同、知识库内容越多,算力成本越高。
二、LLM核心能力清单
1. 基础语言能力:文本续写、摘要总结、改写润色、多语种翻译、关键词提取、分类打标。
2. 逻辑推理能力:算术计算、逻辑判断、方案拆解、因果分析、结构化输出。
3. 知识问答:通用知识、行业资料查询、文档问答(搭配RAG检索增强)。
4. 工具调用(Agent智能体):调用API、数据库、计算器、文件读写、外部系统,完成多步骤复杂任务。
5. 多模态扩展:图文理解,可读取图片、图表、PDF截图,实现图文联合分析。
三、LLM固有短板与能力边界(重点风险)
1. 幻觉问题:模型会编造不存在事实、参考文献、数据,看起来通顺真实,但是内容虚假,专业场景必须人工复核。
2. 知识截止:模型知识库存在固定时间断点,无法自动获取实时新闻、最新政策,需要RAG接入外部知识库补充实时资料。
3. 不稳定推理:简单问题稳定,复杂长链条推理、高精度计算容易出错,每次回答存在随机性。
4. 上下文遗忘:超长文档场景下,容易丢失文档开头信息,存在“中间遗忘”现象。
5. 价值对齐漏洞:容易被提示词越狱诱导,输出违规、偏见内容,企业使用必须增加安全过滤层。
四、主流落地技术方案:RAG / 微调 / Agent
1. RAG检索增强生成(企业最常用)
把企业私有文档、合同、产品手册、合规指南、知识库向量化存入向量数据库;用户提问时,先检索相关资料,再交给大模型基于检索到的真实资料作答。优势:不改模型权重、成本低、资料可控,大幅降低幻觉;适合内部知识库问答、产品咨询、合同审查。
2. 模型微调
用行业专属数据集调整模型权重,让模型固定输出风格、专业术语。分为全参数微调、LoRA轻量微调。成本高于RAG,适合固定格式输出、专业行业话术场景;缺点:数据更新需要重新微调。
3. Agent智能体
大模型作为大脑,自主规划任务步骤,自动调用外部工具,循环执行、校验结果。适合复杂多步骤业务,如自动报表生成、客户线索分析、项目方案撰写。难点:流程稳定性较差,提示词工程要求高。
五、企业落地场景分类
办公&内容生产
方案撰写、PPT提纲、宣传文案、金句生成、会议纪要、简历优化、资讯内容编审,前面健康资讯、招商文案、展会资料均可自动化辅助创作。
企业合规与法务
合同摘要、条款比对、合规风险检索、宣传文案预审、政策文档解读,辅助合规管理工作。
客户服务与招商
智能客服、加盟咨询问答、客户意向识别、询盘信息结构化整理,24小时接待访客。
行业垂直场景
医疗健康科普辅助、供应链资料整理、SD-WAN/充电桩技术文档解析、财税票据与捐赠政策问答。
开发运维场景
代码生成、故障日志分析、运维工单处理、网络配置文档编写。
六、LLM选型维度(公有API / 私有化部署)
公有API调用(SaaS,轻量快速)
优点:无需服务器、开箱即用,按需计费,维护成本低;缺点:数据出内网,敏感资料存在泄露风险,依赖外网。适合文案创作、公开资讯处理、营销业务。
私有化部署(本地/专属服务器)
优点:数据不出本地,隐私可控,内网可用,满足等保、合规要求;缺点:硬件GPU服务器投入高,运维门槛高。适合合同、客户隐私、财税等涉密内部业务。
选型核心指标
上下文窗口大小、推理速度、幻觉控制能力、中文理解能力、工具调用稳定性、GPU硬件要求、许可证、安全过滤、价格/百万token。
七、成本测算参考
公有API:通用大模型 0.5~2元 / 百万输入token,输出token价格更高;轻量私有化小模型:单台GPU服务器1万~10万; 70B以上大模型私有化:多卡集群,硬件投入几十万至数百万,还要持续算力电费运维成本。
八、企业应用合规与风险管控
1. 数据安全:输入模型的客户信息、隐私资料,禁止直接传入公有大模型,避免信息外泄;
2. 内容审核:模型输出内容必须二次审核,专业、对外宣传内容不能直接采信,防范幻觉带来虚假宣传;
3. 版权风险:训练数据、生成内容存在版权隐患,商用场景需评估;
4. 内容红线:搭建安全过滤器,拦截违法、虚假、医疗诊断、金融承诺类内容;
5. 留痕审计:所有调用记录、输入输出日志留存,满足内审与监管追溯。
九、2026 LLM行业核心趋势
1. 模型分化:通用大模型能力持续增强,垂直小模型轻量化、低成本,本地化端侧模型普及;
2. RAG成为标配:企业知识库落地标准化,幻觉抑制技术持续迭代;
3. Agent应用落地加速:智能体从概念走向业务流程自动化;
4. 多模态融合:文本、图片、表格、音视频一体化理解;
5. 行业监管趋严:生成式AI备案、内容标识、数据安全相关规范逐步完善。
十、总结
LLM本质是强大的语言概率生成工具,并非拥有自主意识。企业落地核心思路:**非敏感业务优先公有API+RAG快速验证;涉密业务评估私有化部署;所有输出内容建立人工复核机制**。不夸大模型能力,把LLM作为员工效率助手,而不是完全替代人工,才能规避幻觉、合规、数据安全风险,实现价值落地。
-
 LLM大语言模型典型案例分析|落地实战复盘
概述:本文聚焦2025-2026年已商业化落地、具备真实数据、可复用落地逻辑的四大LLM标杆案例,覆盖金融风控、工业智造、在线教育、智能客服四大核心赛道。统一采用「项目痛点→技术架构→落地流程→落地成效→现存问题→...
-
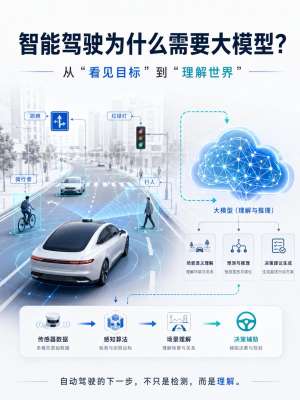 LLM大语言模型落地案例分析报告—以家用智能座舱系统为例
一、案例概述随着生成式人工智能技术快速迭代,LLM大语言模型已从通用对话场景,深度下沉至车载智能座舱垂直领域。传统车机语音系统多为固定指令匹配、语义理解僵化、交互生硬,无法满足家庭多成员...
-
 LLM大模型工具推荐2026完整版|全场景选型指南
2026 LLM选型核心标准:不再只看对话流畅度,重点看长文本理解、真实知识库RAG、多模态质量、Agent智能体能力、国产化合规、稳定输出。以下为目前全网综合体验最强、落地最稳、适配各行各业的主流LLM工具,分场景精准...
-
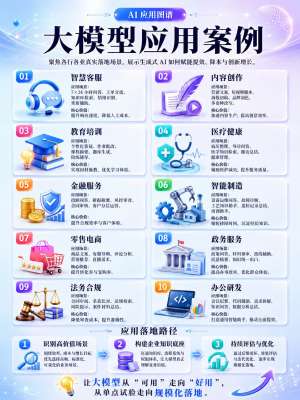 LLM大模型全行业应用场景(2026完整版|落地可用)
本文整理通用+政企+产业+ToB+ToC+车端+教育+医疗+文旅+开发运维全维度LLM落地场景,全部为当前可商业化、可项目落地的真实场景,无概念虚标,适合项目申报、方案撰写、产品规划、赛道调研使用。一、通用基础能力场景...
-
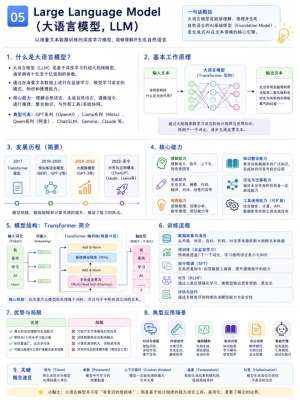 LLM大语言模型深度解析|2026完整版全解
核心前言:2026年是大语言模型从通用对话工具彻底转向产业智能底座、Agent自主生产力的关键拐点。行业认知已全面升级:LLM不再是“会聊天的AI”,而是基于海量数据概率学习、具备语义理解、逻辑推理、工具调用、自主规划、...
-
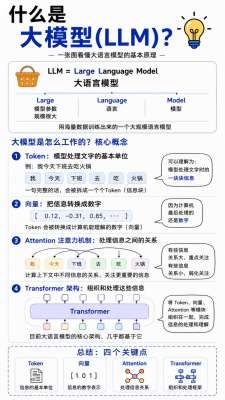 LLM大模型落地最佳实践|全指南
前言:大模型(LLM)已经从“技术demo”进入工业化、工程化、业务化落地阶段。绝大多数企业落地失败,并非模型能力不足,而是缺少标准化落地范式、Prompt混乱、向量库滥用、微调无策略、推理成本失控、幻觉风险未治理。本文总结行业...