GPT常见问题|基础认知、使用、报错、安全、选型完整FAQ指南
GPT常见问题|基础认知、使用、报错、安全、选型完整FAQ指南
前言:GPT是OpenAI推出的生成式大语言模型系列,从GPT-3.5、GPT-4到GPT-4o,是目前应用最广泛的大模型。很多新手在使用、接入API、选型、安全方面会遇到大量共性疑问。本文整理高频问题,区分基础概念、使用疑问、API接入、能力边界、安全合规、选型对比六大板块,通俗易懂,适合企业采购、个人学习、开发对接查阅。
一、基础认知类问题
Q1:GPT是什么?GPT和大语言模型有什么区别?
A:GPT全称Generative Pre-trained Transformer,是基于Transformer架构的预训练生成式大语言模型。GPT属于大语言模型(LLM)其中一个系列,LLM是大类,GPT是OpenAI出品的LLM产品。
Q2:GPT-3.5、GPT-4、GPT-4o核心差别是什么?
A:GPT-3.5:性价比高,文字对话能力强,适合文案、简单问答、基础代码,推理能力偏弱;GPT-4:逻辑推理、复杂计算、长文本理解更强,适合方案撰写、数据分析、复杂业务处理;GPT-4o:多模态版本,同时支持文字、图片、音频输入输出,响应速度更快,可看图识图、语音实时对话。
Q3:ChatGPT和GPT是一回事吗?
A:不是。GPT是底层大模型;ChatGPT是OpenAI推出的网页端对话产品,底层调用GPT模型。简单理解:GPT是引擎,ChatGPT是面向用户的对话界面。
Q4:GPT模型是联网实时搜索的吗?
A:原生GPT模型本身有训练数据截止时间,默认无法自动获取互联网实时信息。开启Browse(联网搜索)功能之后,才可以访问网页获取最新资讯。不开启联网时,只能基于训练知识库回答。
Q5:GPT训练数据截止时间是什么意思?
A:模型学习的数据有固定时间边界,超出这个时间的事件、新闻、新法规,模型本身不知道,没有联网的情况下无法回答。
二、日常使用高频问题
Q6:为什么GPT回答会“胡说八道”(模型幻觉)?
A:大语言模型不是数据库,不会检索事实,而是基于概率生成通顺文本。遇到陌生知识、专业细节、冷门数据,会编造看起来合理但错误的内容,这个现象称为幻觉。重要信息一定要二次核验。
Q7:为什么有时候GPT回答前后矛盾?
A:上下文窗口有限,对话内容过长时,早期对话信息会被遗忘;同时模型是概率生成,同一问题多次提问可能输出不一样的答案,复杂问题建议分段提问,并且给明确约束条件。
Q8:同一个问题,多次提问答案不一样,正常吗?
A:属于正常现象。GPT带有随机性参数(temperature温度),温度越高,答案创意越强、变动越大;调低温度,输出结果会更加稳定、固定。
Q9:GPT能处理多长的文档?
A:取决于模型上下文窗口。GPT3.5支持16k上下文;GPT4支持8k/32k;GPT-4o支持128k上下文,可一次性读取长报告、合同、代码文件。超过上下文长度,模型会丢失前面内容。
Q10:GPT能不能生成图片?
A:原生文本GPT不能画图;GPT系列产品中,可调用DALL-E模型生成图像,属于配套能力,不是LLM本身自带功能。GPT-4o可以识别图片,但不能直接绘图。
三、API接入开发相关问题
Q11:GPT API是什么,和网页ChatGPT有什么区别?
A:API是程序接口,供软件、系统、小程序、企业平台调用模型能力,按token计费;网页ChatGPT是面向个人的网页对话产品,大多是订阅包月。两者计费、调用策略、数据规则不相同。
Q12:Token是什么,怎么估算token消耗?
A:Token是模型处理文本的最小单位,中文大约1个汉字≈1.3token。输入+输出全部都会消耗token,API计费按照总token数量结算。
Q13:API调用报错:速率限制、429是什么意思?
A:429代表请求频次超限,单位时间调用次数达到配额上限。解决方案:降低并发、增加请求间隔、申请提升账户配额。
Q14:API输入的数据,OpenAI会不会用来训练模型?
A:企业客户可通过设置关闭数据用于模型训练;普通用户API提交数据,默认策略会有相关使用规则,敏感业务数据建议做脱敏处理。
四、能力边界与适用场景问题
Q15:GPT可以直接写可上线生产代码吗?
A:可以生成参考代码,但不能直接上线。代码存在漏洞、逻辑缺陷、安全隐患,必须人工审核、单元测试、安全扫描之后再部署。
Q16:GPT能不能做数学、精密工程计算?
A:简单计算没问题,复杂高数、大量精密运算容易出错。适合搭配代码解释器,运行代码完成精准计算。
Q17:GPT可以替代程序员、文案、设计师吗?
A:属于辅助工具,提升工作效率,无法完全替代人。模型输出内容需要人工校验、修改、落地,复杂决策、专业审核必须由人承担。
Q18:GPT能不能处理涉密、内部敏感商业资料?
A:不建议直接上传涉密、核心商业机密、用户隐私数据。存在数据外泄、日志留存风险,企业涉密场景优先考虑私有化部署模型。
五、安全、合规与隐私问题
Q19:使用GPT生成的内容版权归谁?
A:依据OpenAI用户协议,用户拥有生成内容的使用权,但不能保证内容无版权冲突。生成内容可能引用已有作品,商用前需要自行核验。
Q20:GPT会不会记住我的对话,别人能看到我的聊天记录吗?
A:对话内容会保存,用于模型安全审核,普通第三方无法直接查看;可以在设置中关闭对话记录保存。
Q21:使用GPT处理国内个人信息,是否符合《个人信息保护法》?
A:直接把国内用户个人信息提交境外大模型,存在合规风险。企业处理个人信息,需要评估数据出境合规要求,优先选用国内合规大模型。
Q22:为什么GPT会拒绝回答某些问题?
A:内置安全护栏,针对暴力、违法、诈骗、破解、侵权、歧视类问题,会触发内容安全策略,直接拒绝输出。
六、选型与成本相关问题
Q23:个人使用选GPT3.5还是GPT4?
A:日常文案、简单问答、翻译用GPT3.5足够,成本更低;复杂方案、逻辑推理、识图、专业分析,选GPT4/GPT4o。
Q24:GPT包月订阅和API调用哪个更划算?
A:个人少量对话,网页包月订阅更合适;企业系统、程序自动化批量调用,选择API按token计费。
Q25:私有化部署GPT可行吗?
A:OpenAI不提供GPT模型私有化本地部署,私有化场景一般选用国内开源或国产商用大模型。
七、常见报错类问题
Q26:提示网络无法访问/连接超时
A:网络访问限制问题,国内无法直接访问OpenAI官方服务。
Q27:提示内容被屏蔽,“This content may violate our content policy”
A:输入提示词触发安全审查,简化提问,去掉敏感描述,重新组织需求。
Q28:模型输出内容截断,回答到一半停止
A:达到单次输出token上限,或者网络中断。可以指令“继续回答”,让模型续写剩余内容。
八、总结
GPT是强大的生成式AI辅助工具,最大特点是自然语言理解能力强,但存在幻觉、上下文限制、无法天然联网、境外数据合规风险。使用核心原则:AI输出仅作参考,重要事实、专业内容、商用材料,务必人工复核;涉及国内隐私、涉密业务谨慎使用。
-
 LLM大语言模型典型案例分析|落地实战复盘
概述:本文聚焦2025-2026年已商业化落地、具备真实数据、可复用落地逻辑的四大LLM标杆案例,覆盖金融风控、工业智造、在线教育、智能客服四大核心赛道。统一采用「项目痛点→技术架构→落地流程→落地成效→现存问题→...
-
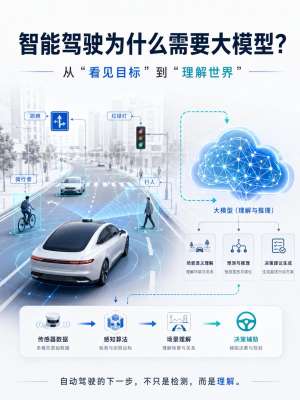 LLM大语言模型落地案例分析报告—以家用智能座舱系统为例
一、案例概述随着生成式人工智能技术快速迭代,LLM大语言模型已从通用对话场景,深度下沉至车载智能座舱垂直领域。传统车机语音系统多为固定指令匹配、语义理解僵化、交互生硬,无法满足家庭多成员...
-
 LLM大模型工具推荐2026完整版|全场景选型指南
2026 LLM选型核心标准:不再只看对话流畅度,重点看长文本理解、真实知识库RAG、多模态质量、Agent智能体能力、国产化合规、稳定输出。以下为目前全网综合体验最强、落地最稳、适配各行各业的主流LLM工具,分场景精准...
-
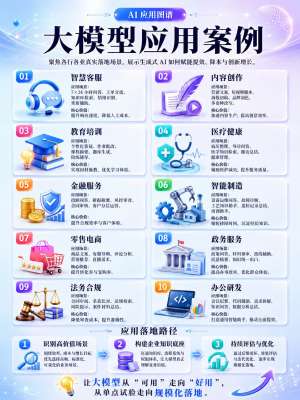 LLM大模型全行业应用场景(2026完整版|落地可用)
本文整理通用+政企+产业+ToB+ToC+车端+教育+医疗+文旅+开发运维全维度LLM落地场景,全部为当前可商业化、可项目落地的真实场景,无概念虚标,适合项目申报、方案撰写、产品规划、赛道调研使用。一、通用基础能力场景...
-
 LLM大语言模型深度解析|2026完整版全解
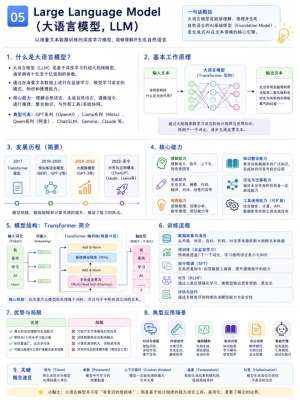
核心前言:2026年是大语言模型从通用对话工具彻底转向产业智能底座、Agent自主生产力的关键拐点。行业认知已全面升级:LLM不再是“会聊天的AI”,而是基于海量数据概率学习、具备语义理解、逻辑推理、工具调用、自主规划、...
-
 LLM大模型落地最佳实践|全指南
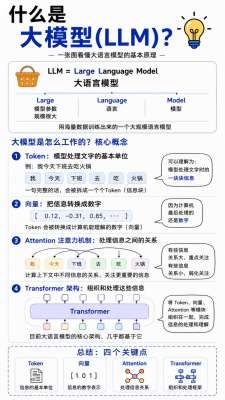
前言:大模型(LLM)已经从“技术demo”进入工业化、工程化、业务化落地阶段。绝大多数企业落地失败,并非模型能力不足,而是缺少标准化落地范式、Prompt混乱、向量库滥用、微调无策略、推理成本失控、幻觉风险未治理。本文总结行业...