大模型入门教程
大模型零基础入门教程
一、基础认知:搞懂什么是大模型
1. 核心定义
LLM 大语言模型,基于Transformer 神经网络,用海量文本、百亿级参数、超大算力训练;本质是预测下一个文字,规模达标后自动涌现推理、写作、逻辑、编程等通用能力。
“大” 三层含义:
参数大:7B(70 亿)、13B、70B、千亿级;
数据大:万亿字互联网、书籍、文献语料;
算力大:依赖 GPU 集群训练。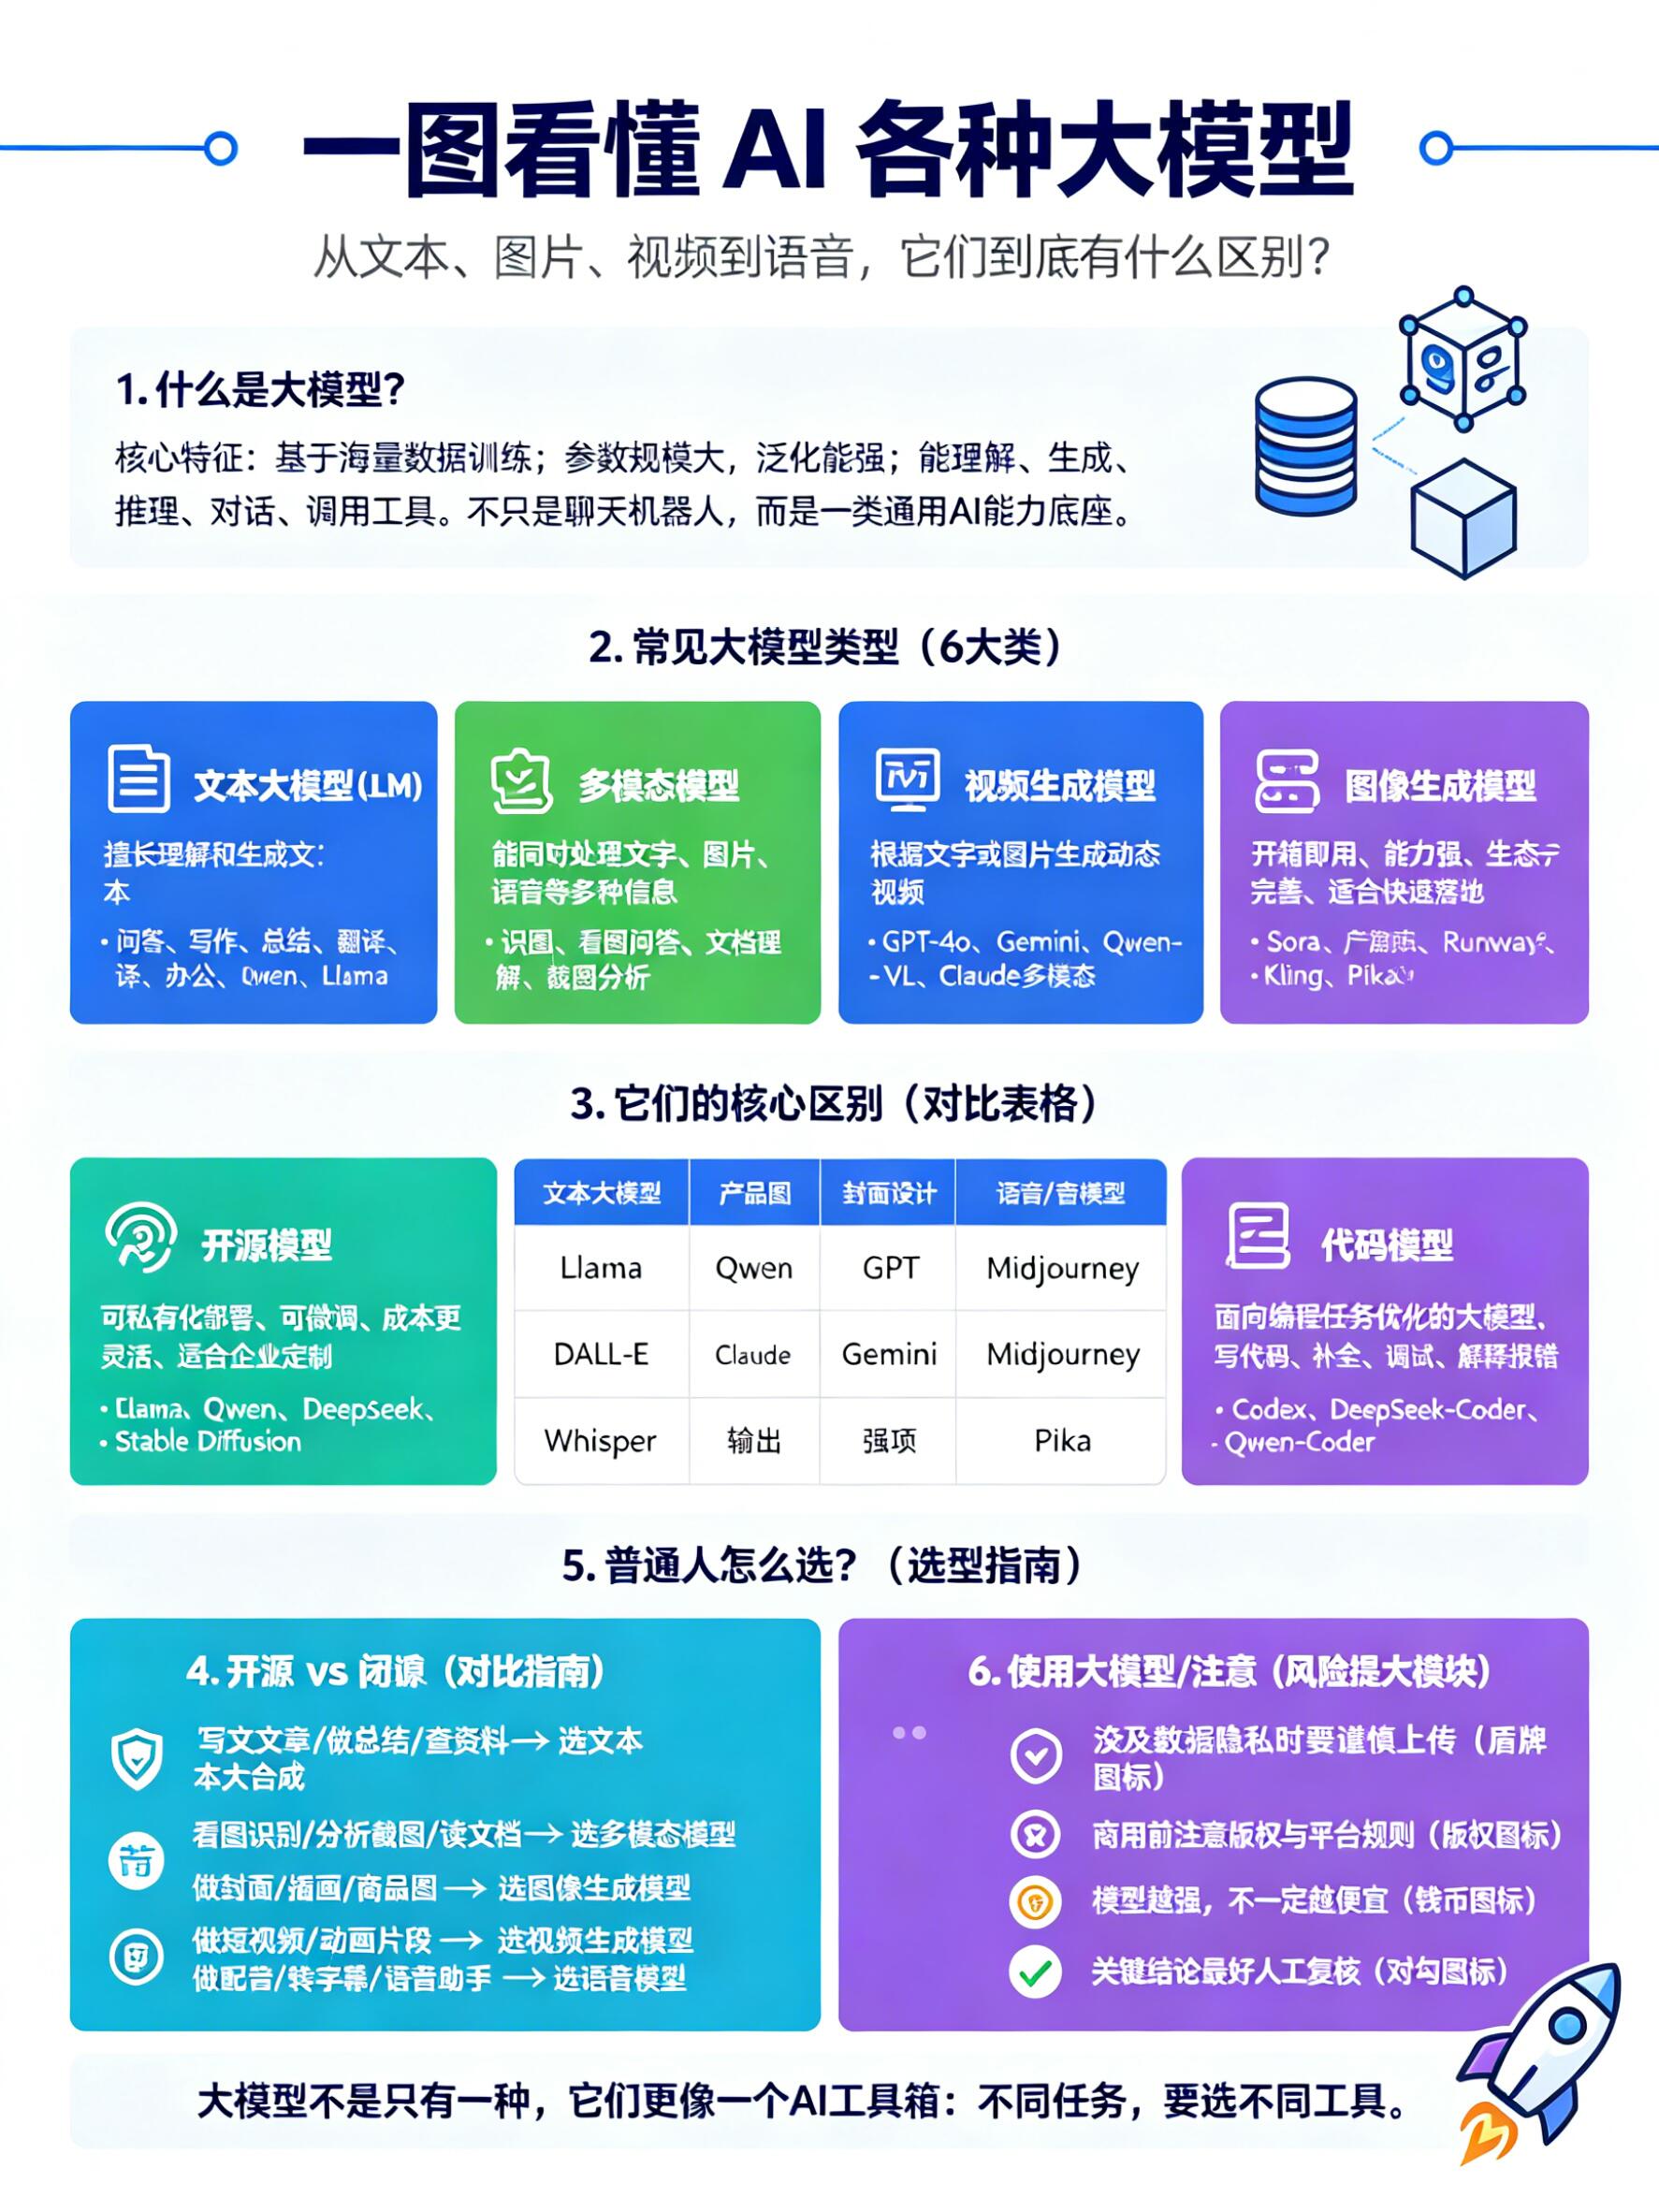
2. 主流分类
闭源商用模型:GPT 系列、通义千问、文心一言、Claude,开箱即用,支持 API 调用;
开源底座模型:Llama、Qwen 通义千问开源、DeepSeek、Llama,可本地部署、二次微调;
多模态大模型:文生图、图文问答(GPT-4V、通义万相);
行业垂直模型:法律、医疗、工业、金融专用微调模型。
3. 入门必记核心术语
Token 词元:模型最小处理单位,中文 1 个字≈1-2 个 Token,上下文窗口限制单次输入总 Token;
Transformer:所有现代大模型底层骨架,核心是自注意力机制(自动抓取上下文关联);
Prompt 提示词:人与模型沟通指令,决定输出质量;
预训练:第一阶段,全网海量无标注数据,学习通用语言知识;
微调 SFT:预训练后,用人工问答数据训练,让模型听懂人类指令;
RAG 检索增强:接入私有文档数据库,解决模型知识过时、“幻觉胡说”;
LoRA 轻量微调:低成本定制专属模型,不用全量重训;
幻觉:模型编造不存在的事实、数据、文献,是最常见缺陷。
二、第一阶段:零基础上手(0-15 天,先会用)
1. 前置最低基础(不用深挖)
Python 基础:会变量、列表、字典、简单接口请求;
数学不用精通:仅需理解梯度、概率、矩阵基础概念,用到再补;
系统:简单 Linux 基础(云服务器部署必备)。
2. 实操渠道(零成本)
网页端直接对话:豆包、文心一言、通义千问、GPT 网页版,练提示词;
API 调用:厂商开放接口,Python 简单代码实现问答、摘要;
开源免费算力:Hugging Face、Google Colab、国内飞桨 AI Studio,可运行开源小模型。
3. 核心技能 1:提示词工程(入门最快见效)
标准万能提示词模板
角色 + 任务 + 要求 + 输出格式 + 示例
示例:
你是专业汽车文案策划,帮我写极氪 001 宣传短文,100 字以内,突出 800V 快充与家用舒适性,分段输出。
进阶技巧
思维链 CoT:让模型分步思考,提升数学 / 逻辑准确率;
少样本学习:给 1-2 个案例,统一输出风格;
限定边界:禁止编造数据、标注信息来源,减少幻觉。
4. 核心技能 2:API 调用最简流程
平台申请密钥 Key;
Python 调用 requests 库,发送 prompt;
接收返回文本,做简单业务处理(摘要、翻译、知识库问答)。
三、第二阶段:核心原理看懂(15-45 天)
1. Transformer 极简原理
分为两大模块:
Encoder 编码器(BERT 类,理解文本,适合分类、检索);
Decoder 解码器(GPT 类,仅单向读取上文,负责文字生成,当前主流大模型只用 Decoder);
核心多头自注意力:计算每个 Token 和全文所有文字的关联权重,看懂上下文逻辑。
2. 大模型完整三阶段训练流程
预训练:海量无标签文本,目标是学会语言、常识、基础知识;成本最高,通用底座来源;
监督微调 SFT:人工标注问答对,教会模型听懂人类指令,对齐人类表达习惯;
人类反馈对齐 RLHF/DPO:人工打分筛选优质回答,优化模型输出偏好,减少有害、无用回答。
3. 关键配套技术
分词器 Tokenizer:把文字转数字 Token,模型唯一输入格式;
嵌入 Embedding:文字转数值向量,用于 RAG 文档相似度检索;
温度 Temperature:参数 0-1,数值越高输出越随机、创造性越强;0 则输出严谨固定。
四、第三阶段:落地实战开发(45-90 天)
1. 最主流落地方案:RAG 知识库系统
解决痛点:通用模型知识滞后、无法读取企业私有文件(合同、手册、内部资料)
完整流程:
文档上传 → 文本分割 → 生成向量入库 → 用户提问转向量 → 检索相似文档片段 → 把文档 + 问题一起丢给大模型 → 输出带资料依据的回答
2. 轻量定制:LoRA 微调
适用场景:行业专属话术、企业专属知识库、特定写作风格
优势:只需少量行业数据,显卡要求低,训练几小时即可,不改动原始模型主体权重。
3. 开发工具框架
LangChain:快速搭建 RAG、对话机器人、多工具调用 Agent;
LlamaIndex:侧重文档检索知识库;
Transformers(Hugging Face):加载、运行开源模型核心库。
4. 私有化本地部署
小参数量 7B/13B 开源模型,家用高端显卡可本地运行;
量化技术(4bit/8bit)大幅降低显存占用,低配设备也能跑;
推理加速框架:vLLM、TensorRT-LLM,提升响应速度、降低显存消耗。
五、第四阶段:进阶方向(按需选择)
1.应用开发岗:深耕 RAG、Agent 智能体、低代码 AI 工具、企业 AI 系统集成;
2.算法微调岗:数据清洗、SFT/RLHF 训练、模型评估、LoRA / 全参数微调;
3.推理部署岗:大模型量化、分布式推理、容器化、云服务优化;
4.研究方向:多模态、混合专家 MoE、超长上下文、小模型蒸馏。
六、避坑学习路线(新手不要本末倒置)
1.不要一上来啃数学、复杂论文;先网页对话练提示词,再调用 API;
2.不要直接训练大模型;先做 RAG 应用,再接触微调;
3.不要只用闭源模型;必须上手开源模型,理解本地运行逻辑;
4.重视数据质量:无论 RAG 还是微调,数据好坏直接决定模型效果。
七、入门学习资源
免费课程
李沐《动手学深度学习》(深度学习基础,大模型前置);
Hugging Face 官方教程(开源模型实操);
吴恩达《Large Language Models Specialization》(LLM 应用入门)。
书籍
《动手学大模型应用开发》(侧重落地项目);
《从零构建大模型》(代码实现 GPT 基础结构)。
开源平台
Hugging Face、ModelScope 魔搭、Github(LangChain、Qwen、Llama 开源项目)。
八、学习阶段目标总结
入门期:熟练写提示词、调用 API、搭建简易 RAG;
原理期:看懂 Transformer、预训练 / 微调完整链路,理解关键参数;
实战期:独立搭建私有知识库、本地部署开源模型、完成 LoRA 微调 Demo;
进阶期:根据岗位方向深耕开发 / 微调 / 推理,产出完整可商用项目。
- 上一页:2025最新新能源汽车推荐2025详解
- 下一页:手机评测选购指南
-
 LLM大语言模型典型案例分析|落地实战复盘
概述:本文聚焦2025-2026年已商业化落地、具备真实数据、可复用落地逻辑的四大LLM标杆案例,覆盖金融风控、工业智造、在线教育、智能客服四大核心赛道。统一采用「项目痛点→技术架构→落地流程→落地成效→现存问题→...
-
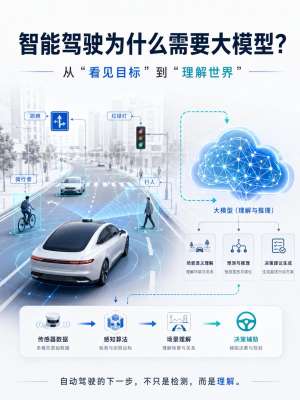 LLM大语言模型落地案例分析报告—以家用智能座舱系统为例
一、案例概述随着生成式人工智能技术快速迭代,LLM大语言模型已从通用对话场景,深度下沉至车载智能座舱垂直领域。传统车机语音系统多为固定指令匹配、语义理解僵化、交互生硬,无法满足家庭多成员...
-
 LLM大模型工具推荐2026完整版|全场景选型指南
2026 LLM选型核心标准:不再只看对话流畅度,重点看长文本理解、真实知识库RAG、多模态质量、Agent智能体能力、国产化合规、稳定输出。以下为目前全网综合体验最强、落地最稳、适配各行各业的主流LLM工具,分场景精准...
-
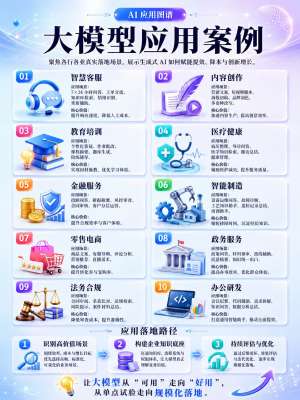 LLM大模型全行业应用场景(2026完整版|落地可用)
本文整理通用+政企+产业+ToB+ToC+车端+教育+医疗+文旅+开发运维全维度LLM落地场景,全部为当前可商业化、可项目落地的真实场景,无概念虚标,适合项目申报、方案撰写、产品规划、赛道调研使用。一、通用基础能力场景...
-
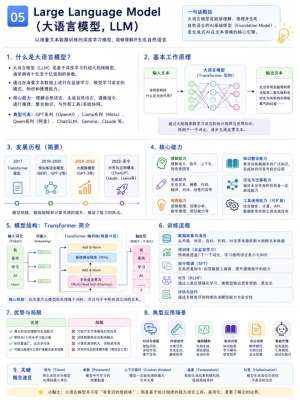 LLM大语言模型深度解析|2026完整版全解
核心前言:2026年是大语言模型从通用对话工具彻底转向产业智能底座、Agent自主生产力的关键拐点。行业认知已全面升级:LLM不再是“会聊天的AI”,而是基于海量数据概率学习、具备语义理解、逻辑推理、工具调用、自主规划、...
-
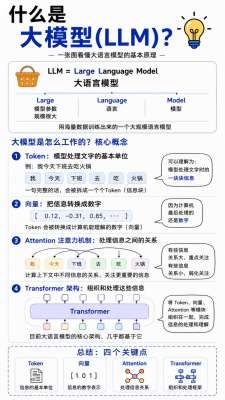 LLM大模型落地最佳实践|全指南
前言:大模型(LLM)已经从“技术demo”进入工业化、工程化、业务化落地阶段。绝大多数企业落地失败,并非模型能力不足,而是缺少标准化落地范式、Prompt混乱、向量库滥用、微调无策略、推理成本失控、幻觉风险未治理。本文总结行业...