GPT避坑指南:2025版|从提示词到落地,避开常见陷阱
GPT避坑指南:2025版|从提示词到落地,避开常见陷阱
核心原则:GPT是强大的助手,但不是万能的。用得好提效十倍,用不好浪费时间还埋雷。本文整理2025年最常见的GPT使用坑点,覆盖个人使用、API开发和企业落地三个层级。
一、Prompt避坑:提问方式决定输出质量
坑1:问题太宽泛,得到的答案也很泛
典型错误提问:"帮我写一篇营销方案"
问题在哪:没有产品、没有目标用户、没有预算、没有渠道,GPT只能给你一篇正确的废话。
正确做法:把背景、目标、约束、输出格式全部写清楚。比如:"我要给一款20万级纯电SUV写小红书种草文案,目标用户是30岁左右一线城市奶爸,预算单篇投放5000元,要求突出续航和空间,输出3个不同角度的标题+正文。"
坑2:角色设定缺失,输出不够专业
典型错误:直接让GPT写代码、写法律文书、写医学内容,不指定专业角色。
问题在哪:GPT默认是"通用助手"风格,写出来的东西不够专业。
正确做法:开头加角色设定。比如:"你是一位有10年经验的资深React前端工程师,精通性能优化最佳实践……"角色越具体,输出越专业。
坑3:一次问太多,GPT抓不住重点
典型错误:一条消息里塞五六个问题,要求同时写方案、写文案、做分析、改代码。
问题在哪:上下文长度有限,问题太多会导致后面的问题质量下降。
正确做法:拆分任务,一条消息聚焦一个目标。复杂任务分步来,先让GPT列大纲,确认后再展开写细节。
坑4:不给示例,输出风格不对
问题在哪:你想要"像乔布斯发布会风格"的文案,但GPT不知道你要什么风格。
正确做法:给1-2个参考示例(Few-shot),告诉GPT"按照这个风格写"。风格类任务,示例比描述管用十倍。
坑5:忘记指定输出格式
典型问题:你想要JSON格式方便程序读取,结果GPT输出了一大段自然语言夹着代码块。
正确做法:明确要求"只输出JSON,不要解释文字"或者"用Markdown表格格式输出"。关键任务可以加一句"如果无法满足格式要求,直接说无法完成,不要自由发挥"。
二、幻觉避坑:GPT一本正经胡说八道怎么办
什么是幻觉
幻觉是GPT最大的坑——它会非常自信地编造不存在的事实、引用、数据、人名、论文,而且语气极其肯定,让你很难分辨真假。
坑1:把GPT当搜索引擎用
典型错误:问GPT"2025年最新的XX政策是什么""XX公司2024年营收多少"。
问题在哪:GPT的训练数据有截止日期,而且它不实时联网。你问它最新数据,它会瞎编一个看起来合理的数字。
正确做法:时效性强的问题,要么自己去查,要么用带联网搜索的版本(如GPT-4o With Search、Perplexity),并且让GPT标注信息来源。
坑2:GPT引用的论文/书籍/法条不存在
典型场景:让GPT写综述、写法律分析,它会引用一堆看起来很正规的论文标题、法条编号、判例,但你一查全是编的。
正确做法:所有引用、数据、人名、法条,必须手动去原始来源核实。GPT给的是"初稿方向",不是"已验证事实"。
坑3:数学计算和逻辑推理出错
典型问题:GPT做复杂数学题、逻辑推理、代码调试时会出错,而且错得很自信。
正确做法:关键计算用Python、计算器或者专门的数学模型(如GPT-4o Advanced/Reasoning模型)验证。代码一定要实际跑一遍,不要看GPT说能跑就信。
坑4:让它回答"不知道"的问题
问题在哪:GPT的训练目标是"生成连贯的回答",不是"诚实说不知道"。遇到它不了解的问题,它会编,而不是说"我不清楚"。
正确做法:在prompt里加一句:"如果你不确定答案,直接说'不确定',不要编造。"这能显著减少幻觉。
三、输出质量避坑:为什么GPT写的东西不好用
坑1:写出来的东西"AI味"太重
典型症状:排比句、"总而言之"、"综上所述"、每段开头都是"首先其次最后",读起来像机器写的。
原因:GPT训练数据里大量书面语和公文风格,默认输出就偏模板化。
解决方法:告诉它"用口语化的中文写,像朋友聊天一样,不要用排比和套话,每段不超过3句话"。写完后自己改一遍,删掉那些正确的废话。
坑2:内容太浅,没有深度
典型问题:问一个专业问题,GPT给你的答案和百度百科差不多,没有洞察。
原因:通用大模型的知识广度够,但深度取决于你怎么问。
解决方法:要求它"给出至少3个反直觉的观点""列出这个领域常见的误区""分析正反两方的争议点"。追问、深挖,不要满足于第一遍回答。
坑3:代码看起来对,实际跑不通
典型问题:GPT写的代码逻辑看起来没问题,但缺少依赖、接口变了、版本不对,一运行就报错。
正确做法:
让GPT写代码时,指定具体的库版本和环境
代码一定要实际运行测试,不要看一眼就上线
复杂代码让它逐行解释,你检查逻辑是否正确
遇到bug把完整报错信息贴给它,让它定位问题
坑4:长文本输出越写越偏
典型问题:让GPT写一篇5000字的长文,写到后面跑题了,或者前后矛盾。
原因:上下文窗口有限,写长文时它会忘记前面的设定。
解决方法:长文先写大纲,确认大纲没问题再分章节写。每次写一个章节,保持上下文聚焦。
四、数据安全与隐私避坑:什么不能喂给GPT
最重要的一条:你发给GPT的内容,默认会被OpenAI用于服务改进(除非关闭相关设置)。公司机密、用户隐私、未公开的产品信息,绝对不要直接贴进公开版GPT里。
坑1:把公司机密直接粘进去
典型场景:产品经理把未发布的产品方案、定价、用户数据直接贴给GPT让它润色。
风险:这些数据可能被用于模型训练,或者被员工意外泄露。如果公司有数据合规要求,这是严重违规。
正确做法:
使用企业版(ChatGPT Team/Enterprise),数据不用于训练
敏感数据脱敏后再用——把真实公司名换成"A公司",真实数据换成示例数据
不要在公共GPT里贴客户信息、员工信息、财务数据
坑2:上传文件不注意权限
问题在哪:GPT的文件上传功能会把你的文件内容发给OpenAI服务器。如果你上传的是包含敏感信息的文档,风险同上。
坑3:API Key泄露
典型问题:把API Key硬编码在前端代码里、提交到GitHub公开仓库,被人扫到后疯狂刷接口,账单爆炸。
正确做法:API Key只放在后端环境变量里;设置用量上限和告警;定期轮换Key;绝对不要提交到公开代码仓库。
五、API与成本避坑:调用GPT的隐藏坑
坑1:Token计费,不是按字数
新手误区:以为是按"字数"收费,结果账单远超预期。
实际规则:按Token计费。1个中文字大约是1.5-2个Token。输入和输出分开计费,输出比输入贵。
省钱技巧:
系统提示词(System Prompt)尽量精简,因为每轮对话都会重复计费
不需要长输出时,设置max_tokens限制输出长度
简单任务用便宜的模型(如gpt-4o-mini),复杂任务才用高端模型
缓存重复使用的上下文(Prompt Caching),能省不少钱
坑2:上下文窗口超限
典型问题:对话越来越长,突然报错说超出上下文限制。
原因:每轮对话都会把之前所有消息发给模型,对话越长,输入Token越多,直到超出窗口上限。
解决方法:
定期开新对话,不要在一个对话里聊几个小时
长文档用Embedding+RAG方案,不要直接塞进上下文
用摘要代替完整历史:让GPT总结之前的对话,后续用摘要继续
坑3:流式输出(Streaming)的坑
问题在哪:用流式输出时,如果中间出错,已经返回的内容没法回退。而且流式模式下错误处理更复杂。
建议:关键业务先跑非流式,确认逻辑正确后再切换流式优化体验。
坑4:不处理速率限制(Rate Limit)
典型问题:并发量一上来就429报错,用户体验很差。
正确做法:做好请求队列和重试机制;根据自己的套餐级别控制并发量;重要接口加降级方案。
六、合规与版权避坑:GPT生成的东西能商用吗
坑1:版权归属不清晰
问题在哪:你用GPT生成的文章、代码、图片,版权归谁?GPT训练数据里有受版权保护的内容,生成的内容可能不小心和原作品撞车。
现状:OpenAI的用户协议里明确:你输入的内容归你,你生成的输出内容也归你(在遵守使用条款的前提下)。但实际司法实践还在发展中。
建议:
重要商用内容自己做二次修改和原创性加工
不要让GPT直接复制已有作品的风格和内容
发表前做查重,避免和现有作品高度相似
坑2:输出有害内容或违法内容
问题在哪:即使你不是故意的,GPT可能在prompt引导下生成违法、侵权、违规内容。如果公司产品上线后出现这类内容,责任在产品方。
正确做法:产品层面加输入过滤和输出审核;高风险场景(如医疗、法律、金融)加人工复核。
坑3:深度伪造与AI生成内容标识
趋势:2025年各国都在出台AI生成内容标识法规。国内要求AI生成内容明确标识。做内容产品时,记得加上"本内容由AI生成"的标注。
七、企业级使用避坑:团队落地常见问题
坑1:买了企业版没人用
典型问题:公司花大价钱买了ChatGPT企业版,结果员工还是自己用个人版,或者根本不用。
原因:没有培训、没有场景、没有和工作流结合。工具再好,不知道怎么用也是白搭。
解决方法:先找几个高频场景试点(如客服话术、代码辅助、文档总结),做出效果再推广;组织内部分享会,让用得好的人分享经验。
坑2:把GPT当万能解决方案
典型问题:觉得上了大模型就能解决所有问题,结果发现客服机器人答非所问、代码助手写的代码一堆bug,口碑崩盘。
正确认知:GPT是"增强工具",不是"替代方案"。它适合辅助人,不适合直接面向用户做无人工兜底的全自动产品。关键业务必须有人工审核环节。
坑3:忽视Prompt资产沉淀
典型问题:每个员工都在自己写prompt,质量参差不齐,优秀的prompt散落在各人手里,人走了经验也带走了。
解决方法:建立团队Prompt库,把高频场景的优秀prompt沉淀下来,统一管理和迭代。
八、2025年最新避坑要点
1. 不要迷信"最新最强模型"
新模型不一定适合你的场景。很多时候,便宜快速的小模型效果足够,成本还低。先做评测,再选模型,不要盲目追新。
2. RAG不是银弹
很多人觉得接了RAG就能解决幻觉问题。实际上RAG也会有检索不准、文档不相关、回答还是错的问题。RAG需要持续调优,不是接完就完事。
3. 多Agent协作坑更多
2025年很火的Multi-Agent方案,听起来很酷,但实际落地时:Agent之间上下文传递丢失、任务分工模糊、错误累积放大。简单任务单Agent够用,复杂任务再考虑多Agent。
4. 评测体系比模型选择更重要
没有好的评测,你根本不知道改了prompt、换了模型之后效果是变好还是变差。企业落地第一步应该是建一个评测集,持续量化优化。
最后总结:GPT避坑的核心就三句话——提问要具体,输出要验证,数据要脱敏。把这三条做到位,就能避开90%的常见坑。GPT是强大的工具,但工具的边界和风险,永远要自己心里有数。
-
 LLM大语言模型典型案例分析|落地实战复盘
概述:本文聚焦2025-2026年已商业化落地、具备真实数据、可复用落地逻辑的四大LLM标杆案例,覆盖金融风控、工业智造、在线教育、智能客服四大核心赛道。统一采用「项目痛点→技术架构→落地流程→落地成效→现存问题→...
-
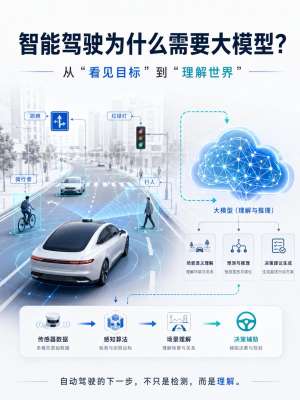 LLM大语言模型落地案例分析报告—以家用智能座舱系统为例
一、案例概述随着生成式人工智能技术快速迭代,LLM大语言模型已从通用对话场景,深度下沉至车载智能座舱垂直领域。传统车机语音系统多为固定指令匹配、语义理解僵化、交互生硬,无法满足家庭多成员...
-
 LLM大模型工具推荐2026完整版|全场景选型指南
2026 LLM选型核心标准:不再只看对话流畅度,重点看长文本理解、真实知识库RAG、多模态质量、Agent智能体能力、国产化合规、稳定输出。以下为目前全网综合体验最强、落地最稳、适配各行各业的主流LLM工具,分场景精准...
-
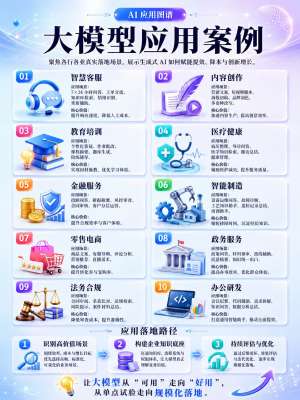 LLM大模型全行业应用场景(2026完整版|落地可用)
本文整理通用+政企+产业+ToB+ToC+车端+教育+医疗+文旅+开发运维全维度LLM落地场景,全部为当前可商业化、可项目落地的真实场景,无概念虚标,适合项目申报、方案撰写、产品规划、赛道调研使用。一、通用基础能力场景...
-
 LLM大语言模型深度解析|2026完整版全解
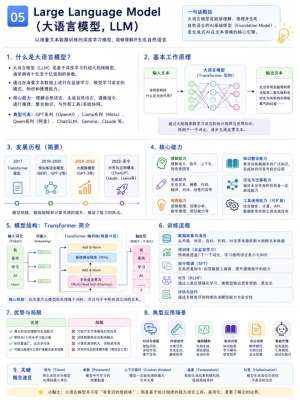
核心前言:2026年是大语言模型从通用对话工具彻底转向产业智能底座、Agent自主生产力的关键拐点。行业认知已全面升级:LLM不再是“会聊天的AI”,而是基于海量数据概率学习、具备语义理解、逻辑推理、工具调用、自主规划、...
-
 LLM大模型落地最佳实践|全指南
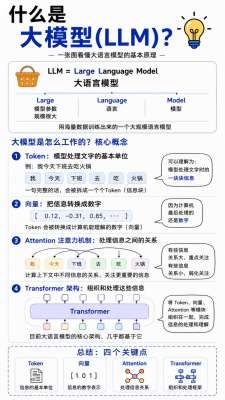
前言:大模型(LLM)已经从“技术demo”进入工业化、工程化、业务化落地阶段。绝大多数企业落地失败,并非模型能力不足,而是缺少标准化落地范式、Prompt混乱、向量库滥用、微调无策略、推理成本失控、幻觉风险未治理。本文总结行业...