GPT完整教程-技术原理、使用方法、国内合规替代方案
GPT完整教程-技术原理、使用方法、国内合规替代方案
一、GPT 是什么
GPT(Generative Pre-trained Transformer)是 OpenAI 开发的大语言模型系列,核心思路是用 Transformer 架构的 Decoder 部分做自回归语言建模——给定前文,逐 token 预测下一个最可能的词。从 GPT-1(2018)到 GPT-4(2023)再到后续的 GPT-4o、o1 等,模型规模、训练数据量和推理能力持续跃升。
关键里程碑:
GPT-1/2/3:验证了"规模定律"(Scaling Law),即模型越大、数据越多、算力越足,能力越强。
ChatGPT(基于 GPT-3.5/4):引入 RLHF(人类反馈强化学习),让模型从"能说话"变成"说人话、听话、有礼貌"。
GPT-4o / o1 系列:多模态(文本+图像+音频统一处理)、推理链(Chain of Thought)能力显著增强。
二、核心技术原理(想深入理解必读)
1)Transformer 架构
GPT 用的是 Transformer 的 Decoder-only 结构,核心组件包括:
自注意力机制(Self-Attention):让模型在处理每个词时"看到"前面所有词,计算它们之间的关联权重。
多头注意力(Multi-Head Attention):把注意力拆成多个"头"并行计算,捕获不同维度的语义关系。
位置编码(Positional Encoding):Transformer 本身不感知顺序,需要额外注入位置信息(GPT 系列使用旋转位置编码 RoPE 或 ALiBi 等)。
前馈网络(FFN):每层注意力之后接一个两层 MLP,做非线性变换。
2)预训练 + 微调范式
预训练(Pre-training):在海量文本上做"下一个 token 预测",学到语言的统计规律、世界知识和推理模式。
监督微调(SFT):用人工标注的"问题-回答"对教模型按指令格式输出。
RLHF / RLAIF:让人类标注员对模型输出排序,训练一个奖励模型,再用 PPO 等强化学习算法优化策略。这一步决定了模型是否"好用"。
3)推理时的关键技术
KV Cache:缓存已计算过的 Key/Value 向量,避免重复计算,是自回归推理速度的核心。
FlashAttention:优化注意力计算的显存访问模式,大幅降低显存占用和延迟。
推测解码(Speculative Decoding):用小模型先猜几个 token,大模型一次性验证,加速生成。
量化(Quantization):将 FP16/BF16 权重压缩到 INT8/INT4,降低部署门槛。
三、如何使用 GPT(API 与产品层面)
1)ChatGPT 产品
OpenAI 官方提供的对话产品,支持免费和付费(Plus/Team/Enterprise)版本。需要注意的是,ChatGPT 的官方服务在中国大陆未直接开放,使用需要符合相关网络管理规定。
2)OpenAI API
开发者通过 API 调用 GPT 模型能力,典型流程:
注册 OpenAI 开发者账号,获取 API Key
按 token 计费(输入 token + 输出 token 分别计价)
通过 HTTP 请求发送 prompt,接收模型生成的 completion
关键参数:model(选模型)、temperature(控制随机性,0 为确定性输出)、max_tokens(最大生成长度)、top_p(核采样)
3)国内合规替代方案
如果无法直接使用 OpenAI 服务,国内有大量同等能力的大模型可供选择:
通义千问(Qwen):阿里巴巴出品,开源版本(Qwen2.5 系列)在多项基准上表现优异,支持 API 调用和本地部署。
文心一言(ERNIE Bot):百度出品,中文理解能力强。
DeepSeek:DeepSeek-V3/R1 系列,推理能力突出,开源且性价比高。
智谱 GLM 系列:清华系,GLM-4 综合能力均衡。
Kimi(月之暗面):长上下文处理能力突出。
豆包(字节跳动):日常对话与创作场景体验好。
这些模型均提供 API 接口,使用方式与 OpenAI API 高度相似(很多甚至兼容 OpenAI 的 SDK 格式),可以直接替换。
四、Prompt 工程:让 GPT 真正好用的核心技能
无论用哪个模型,提示词(Prompt)的质量直接决定输出质量。
1)基本原则
明确角色:告诉模型"你是一位资深XX专家"。
给出上下文:提供足够的背景信息,不要让模型猜。
指定输出格式:明确要求 JSON、Markdown、表格、分点列举等。
分步思考(Chain of Thought):复杂任务让模型"先分析,再回答",准确率显著提升。
少样本示例(Few-shot):给一两个输入-输出示例,模型会模仿格式和风格。
2)常见场景模板
文本生成:角色 + 任务 + 约束 + 格式
代码编写:语言/框架 + 功能描述 + 边界条件 + 错误处理要求
数据分析:数据描述 + 分析目标 + 输出要求(图表/结论/代码)
翻译润色:原文 + 目标语言 + 风格要求(正式/口语/学术)
3)高级技巧
System Prompt 设计:在 API 调用中通过 system message 设定模型的行为边界和人格。
RAG(检索增强生成):把模型和外部知识库结合,先检索相关文档片段,再让模型基于这些片段回答,解决"幻觉"和知识时效性问题。
Agent / Function Calling:让模型调用外部工具(搜索、计算、数据库查询),从"对话助手"升级为"任务执行者"。
五、本地部署 GPT 类模型(技术向)
如果需要在本地或私有环境运行大模型(数据不出域、无 API 费用、离线可用),主流方案:
模型获取:从 HuggingFace 或 ModelScope 下载开源权重(如 Qwen2.5、Llama 3、DeepSeek-V2 等)。
推理框架:vLLM(高吞吐)、llama.cpp(CPU/边缘设备)、Ollama(一键本地运行)、TensorRT-LLM(NVIDIA GPU 极致优化)。
硬件需求参考:7B 模型 INT4 量化约需 6GB 显存;70B 模型 FP16 需约 140GB 显存(多卡或 A100/H100)。
微调:LoRA/QLoRA 可以在单卡上对 7B~70B 模型做参数高效微调,适配特定领域任务。
六、学习路径建议
入门阶段:先用 ChatGPT 或国内模型(通义千问、DeepSeek)日常对话,感受能力边界;学习基本的 Prompt 技巧。
进阶阶段:学习 API 调用(Python + openai SDK 或对应国产 SDK),尝试构建简单应用(聊天机器人、文档问答、代码助手)。
深入阶段:理解 Transformer 原理(推荐 Jay Alammar 的图解系列或李宏毅的课程);学习 RAG 架构(LangChain / LlamaIndex);尝试微调开源模型。
前沿阶段:关注 Agent 框架(AutoGPT、CrewAI、MetaGPT)、多模态模型、推理时计算(Test-time Compute)、模型安全与对齐。
-
 LLM大语言模型典型案例分析|落地实战复盘
概述:本文聚焦2025-2026年已商业化落地、具备真实数据、可复用落地逻辑的四大LLM标杆案例,覆盖金融风控、工业智造、在线教育、智能客服四大核心赛道。统一采用「项目痛点→技术架构→落地流程→落地成效→现存问题→...
-
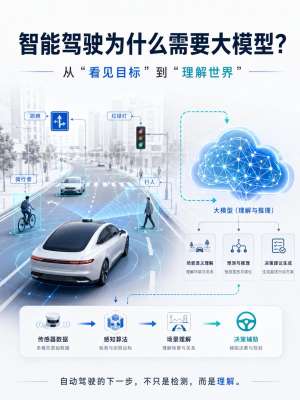 LLM大语言模型落地案例分析报告—以家用智能座舱系统为例
一、案例概述随着生成式人工智能技术快速迭代,LLM大语言模型已从通用对话场景,深度下沉至车载智能座舱垂直领域。传统车机语音系统多为固定指令匹配、语义理解僵化、交互生硬,无法满足家庭多成员...
-
 LLM大模型工具推荐2026完整版|全场景选型指南
2026 LLM选型核心标准:不再只看对话流畅度,重点看长文本理解、真实知识库RAG、多模态质量、Agent智能体能力、国产化合规、稳定输出。以下为目前全网综合体验最强、落地最稳、适配各行各业的主流LLM工具,分场景精准...
-
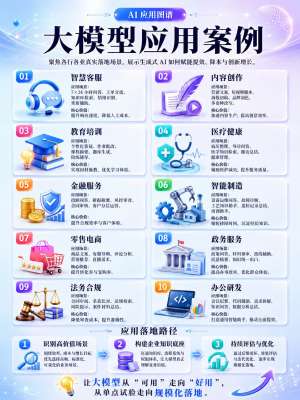 LLM大模型全行业应用场景(2026完整版|落地可用)
本文整理通用+政企+产业+ToB+ToC+车端+教育+医疗+文旅+开发运维全维度LLM落地场景,全部为当前可商业化、可项目落地的真实场景,无概念虚标,适合项目申报、方案撰写、产品规划、赛道调研使用。一、通用基础能力场景...
-
 LLM大语言模型深度解析|2026完整版全解
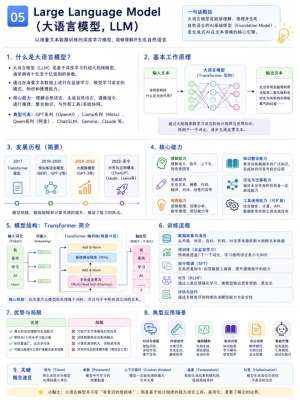
核心前言:2026年是大语言模型从通用对话工具彻底转向产业智能底座、Agent自主生产力的关键拐点。行业认知已全面升级:LLM不再是“会聊天的AI”,而是基于海量数据概率学习、具备语义理解、逻辑推理、工具调用、自主规划、...
-
 LLM大模型落地最佳实践|全指南
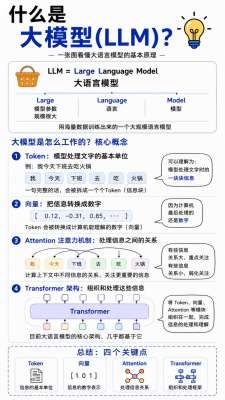
前言:大模型(LLM)已经从“技术demo”进入工业化、工程化、业务化落地阶段。绝大多数企业落地失败,并非模型能力不足,而是缺少标准化落地范式、Prompt混乱、向量库滥用、微调无策略、推理成本失控、幻觉风险未治理。本文总结行业...