GPT 落地案例深度分析(2026 版)
GPT 落地案例深度分析(2026 版)
说明:这里的 GPT 泛指基于大语言模型的生成式 AI
应用,案例覆盖企业服务、营销、研发、教育、客服、供应链,每个案例包含背景、落地方案、实现效果、存在短板、可复用启示,适合行业汇报、方案参考。区分两类:业务降本类案例、增量创新类案例,同时标注落地风险。
案例 1:制造业|GPT 辅助售后技术工单处理(降本类)
项目背景
大型装备制造企业,售后工单量大,客户咨询混杂文字、故障照片描述;客服人员需要翻阅厚重手册,新人上手慢,夜间工单响应滞后,售后人力成本高,工单平均处理时长 45 分钟。
落地方案
知识库底座:把设备手册、历史故障工单、维修方案、配件清单全部入库,搭建 RAG;
GPT 应用层:接收客户故障描述,自动匹配故障根因,生成初步排查步骤、配件编码;
分层流转:简单故障 AI 直接输出回复给到客户;复杂故障自动整理摘要、打上标签,推送给工程师;
配套校验:工程师确认方案后,优质对话自动回流知识库持续优化;设置敏感故障(安全类)强制人工审核。
落地效果
工单平均处理时长压缩至 12 分钟;简单问题 AI 自助解决率 52%;新人培训周期从 2 个月缩短至 2 周;售后人力投入减少 30%,客户满意度提升 18%。
短板与踩坑
早期容易编造不存在配件型号、错误维修步骤;
专业术语、非标定制设备的故障识别准确率偏低;
必须定期更新知识库,否则旧方案会误导用户。
启示
工业场景不能直接裸用 GPT,RAG + 人工复核是底线,专业数据的质量决定 AI 可用度。
案例 2:品牌营销|GPT 全链路内容生产 + 投放素材(增量 + 提效)
项目背景
消费品品牌,抖音、小红书、公众号、官网多渠道运营,内容需求量大:种草文案、短视频脚本、评论回复、活动海报文案、竞品监测简报;文案团队加班多,风格统一难保证,内容迭代慢。
落地方案
设定品牌风格 Prompt 库,固定品牌话术、禁用词、调性;
GPT 批量产出初稿:小红书笔记、短视频口播、活动海报文案、朋友圈素材;
辅助创意:提炼卖点、生成不同角度选题、撰写投放标题 A/B 测试组;
评论风控:自动监控评论,生成合规回复,敏感舆情实时标记推运营。
落地效果
内容产出效率提升 4 倍;同等人力下,每周内容数量从 20 篇提升至 80 篇;A/B 标题测试帮助短视频点击率平均提升 9%;节省大量初稿撰写时间,团队重心转移到创意策划和内容审核。
短板
AI 文案同质化严重,直接发布容易流量下滑;容易夸大宣传,触碰广告合规红线,所有对外内容必须人工审核。
启示
GPT 适合做初稿、备选素材、批量变体;创意内核、合规把关、差异化表达仍然依靠人。
案例 3:软件研发|GPT 辅助代码开发、文档与缺陷复盘(技术团队)
项目背景
中小软件团队,后端、前端需求迭代快,开发文档经常滞后;查接口、写单元测试、排查报错日志消耗大量时间。
落地方案
私有代码库 RAG,接入内部接口文档、历史项目规范;
用 GPT 做:需求转伪代码、代码注释、单元测试脚本、报错日志解读、代码重构建议;
代码评审辅助:扫描代码里的安全漏洞、不规范写法,输出评审意见;
限制:核心加密业务代码不直接上传公有 GPT,部署私有化大模型。
落地效果
普通业务功能开发速度提升 25%;文档补齐工作量大幅下降;新人看懂老项目代码的时间明显缩短。
短板
GPT 容易生成可编译但是逻辑错误的 “幻觉代码”;不理解复杂业务上下文,不能直接上线;不适合高安全等级底层核心代码。
启示
适合辅助、查错、写样板代码;核心业务逻辑、安全模块必须人工深度复核。
案例 4:人力资源|GPT 面试辅助、简历初筛、员工问答机器人
项目背景
企业招聘量大,HR 每天筛选大量简历、重复回答员工福利、考勤、报销、入职问题,占用大量事务性时间。
落地方案
简历解析:GPT 提取简历技能、项目、工作年限,匹配岗位 JD 打分,生成初筛评语;
面试题库:根据岗位自动生成面试提问、追问方向,面试后自动整理面试纪要;
员工自助问答机器人:对接员工手册、考勤制度、报销流程,回答内部高频咨询。
落地效果
简历初筛时间减少 60%;HR 从重复性问答里释放精力,聚焦面试、人才评估;新员工咨询响应 7×24 小时可用。
短板
容易歧视性打分、忽略简历隐性亮点;无法判断候选人真实软素质;面试纪要会丢失情绪、肢体信号信息。
启示
只能作为筛选工具,终面、人才判断完全不能交给 AI,做好提示词公平性校准。
案例 5:跨境电商|GPT 多语种商品文案、买家沟通、市场情报
项目背景
跨境卖家,同时运营欧美、东南亚站点,多语种 Listing、站内邮件、差评回复、平台咨询,翻译成本高,本地化表达生硬。
落地方案
中文卖点输入,GPT 生成符合海外本土习惯的 Listing 标题、五点描述;
自动翻译、润色买家消息,生成售后协商、差评安抚话术;
抓取竞品评价,GPT 提炼用户痛点、热门需求,输出周报。
落地效果
多语种 Listing 产出效率提升 3 倍;差评响应速度更快,差评挽回率提升;省去大量外包翻译费用。
短板
不同国家法规、广告话术限制容易踩坑;小语种方言、本地化俚语容易出错;平台对 AI 生成内容有一定风控。
案例 6:教育机构|GPT 分层题库、学情答疑、教研辅助(合规场景)
项目背景
职业教育机构,需要给学员答疑、组卷、整理错题、生成课后练习,老师答疑压力大。
落地方案
基于课程讲义搭建知识库;GPT 根据学员水平,生成分层练习题;
答疑机器人,只在课程范围内解答,禁止直接输出考试答案;
教研辅助:整理学员高频错题,生成教研改进报告。
注:严格规避 K12 学科辅导红线,本案例仅限成人职教、学历提升。
短板
容易直接给出标准答案,削弱思考;必须设置防直接答题规则。
二、反面失败案例(避坑重点)
失败案例:某金融公司直接用公有 GPT 对外做理财咨询
问题:没有 RAG、没有业务知识库,GPT 随意生成理财收益预测、风险描述,出现误导话术,违反金融监管要求,被监管警示,项目紧急下线。
总结:强监管行业(金融、医疗、法律),裸用公有 GPT 对外提供专业意见风险极高。
失败案例:电商公司直接把 GPT 文案一键上架
问题:AI 生成内容出现绝对化广告词(最、第一、100% 见效),被市场监管处罚,店铺扣分。
三、通用落地方法论(所有 GPT 项目通用)
区分目标:是提效(写初稿、整理、翻译、摘要),还是自主决策(不推荐);绝大多数稳妥落地场景都属于前者;
优先 RAG:把私有资料放进知识库,减少幻觉;
分级审核:低风险内容 AI 自动输出;中风险人工抽查;高风险强制人工终审;
提示词标准化:建立企业提示词库、禁用词库、品牌规范;
数据安全:敏感数据(客户隐私、合同、核心代码)优先私有化部署,禁止直接喂公有 GPT;
效果指标:不要只看好玩,设置量化指标:处理时长、人工节省率、错误率、客户满意度。
四、选型判断一句话总结
✅ 适合 GPT:信息整理、初稿生成、翻译、摘要、标签分类、基础问答、素材批量变体、日志解析 ⚠️ 谨慎使用:医疗诊断、法律咨询、理财投资、设备维修方案、合同终审、人才录用决策 ❌ 禁止直接交给 GPT 独立决策、对外输出强专业结论
-
 LLM大语言模型典型案例分析|落地实战复盘
概述:本文聚焦2025-2026年已商业化落地、具备真实数据、可复用落地逻辑的四大LLM标杆案例,覆盖金融风控、工业智造、在线教育、智能客服四大核心赛道。统一采用「项目痛点→技术架构→落地流程→落地成效→现存问题→...
-
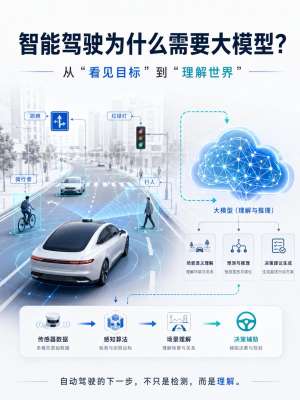 LLM大语言模型落地案例分析报告—以家用智能座舱系统为例
一、案例概述随着生成式人工智能技术快速迭代,LLM大语言模型已从通用对话场景,深度下沉至车载智能座舱垂直领域。传统车机语音系统多为固定指令匹配、语义理解僵化、交互生硬,无法满足家庭多成员...
-
 LLM大模型工具推荐2026完整版|全场景选型指南
2026 LLM选型核心标准:不再只看对话流畅度,重点看长文本理解、真实知识库RAG、多模态质量、Agent智能体能力、国产化合规、稳定输出。以下为目前全网综合体验最强、落地最稳、适配各行各业的主流LLM工具,分场景精准...
-
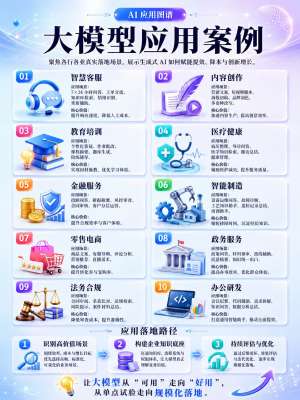 LLM大模型全行业应用场景(2026完整版|落地可用)
本文整理通用+政企+产业+ToB+ToC+车端+教育+医疗+文旅+开发运维全维度LLM落地场景,全部为当前可商业化、可项目落地的真实场景,无概念虚标,适合项目申报、方案撰写、产品规划、赛道调研使用。一、通用基础能力场景...
-
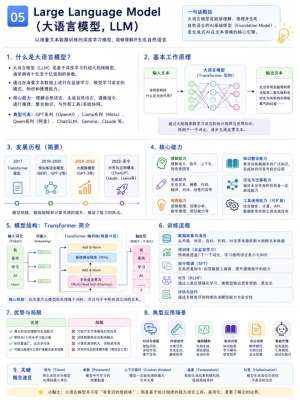 LLM大语言模型深度解析|2026完整版全解
核心前言:2026年是大语言模型从通用对话工具彻底转向产业智能底座、Agent自主生产力的关键拐点。行业认知已全面升级:LLM不再是“会聊天的AI”,而是基于海量数据概率学习、具备语义理解、逻辑推理、工具调用、自主规划、...
-
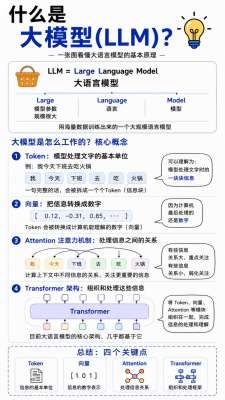 LLM大模型落地最佳实践|全指南
前言:大模型(LLM)已经从“技术demo”进入工业化、工程化、业务化落地阶段。绝大多数企业落地失败,并非模型能力不足,而是缺少标准化落地范式、Prompt混乱、向量库滥用、微调无策略、推理成本失控、幻觉风险未治理。本文总结行业...