GPT 从入门到精通完整指南
GPT 从入门到精通完整指南
说明:GPT 泛指 OpenAI 大模型系列(GPT-3.5、GPT-4o
等),本文覆盖基础使用、提示词工程、进阶调用、落地开发、避坑与能力边界,适合从零开始系统学习。
一、入门阶段:基础认知与上手使用
1. 核心概念
GPT 是基于 Transformer 架构的生成式大语言模型,本质是预测下一个文字,不是拥有自我意识;它擅长文本生成、理解、归纳、翻译、推理,但会产生幻觉(编造事实、文献、数据)。区分版本:
GPT-3.5:速度快、成本低,日常文案、简答、初稿
GPT-4 / GPT-4o:推理更强、支持图文输入、复杂逻辑、长文本,适合专业分析、方案撰写、代码、多模态任务
2. 基础使用规则
清晰提问,避免模糊一句话;
一次尽量聚焦一个任务,不要同时丢多个复杂需求;
发现回答跑偏、出错,直接指出问题,让它修正;
敏感信息不要上传:身份证、手机号、公司机密、未公开业务数据。
3. 入门万能提示词模板(直接套用)
角色:你是【XX专家】
任务:帮我完成【目标】
要求:输出风格、字数、结构、禁止内容
参考材料:【粘贴内容】
示例:你是新媒体文案,写一篇汽车快讯,简洁专业,300 字以内,不要夸大营销话术。
4. 入门高频场景
摘要总结、翻译、改写润色、写清单、简单科普、基础代码、头脑风暴。
二、进阶阶段:提示词工程(核心重点)
1. 主流提示技巧
角色设定法:赋予身份,约束回答口吻、专业度(律师、产品经理、测试工程师)
Few-shot 少样本:给 2-3 个正确示例,让模型模仿格式输出
思维链 CoT:要求 “一步步思考,先列出推导过程再给结论”,大幅提升数学、逻辑、方案类正确率
句式:请分步思考,写出每一步推理,最后给出最终答案
限定输出格式:强制 JSON、Markdown 表格、思维导图大纲、PPT 提纲
逆向提示 / 负面约束:明确禁止内容,例如:不要空话、不要编造数据、不要使用网络鸡汤
自我校验:回答完成后,让模型自查漏洞、幻觉、逻辑矛盾
2. 长文本处理策略
长文档:拆分分段读取,或者使用文件上传功能;
超长材料:先做索引摘要,再基于摘要问答;
风险:上下文窗口有上限,超出后会遗忘前面信息。
3. 多模态使用(GPT-4o)
支持图片 + 文字提问:截图解析、图纸解读、表格识别、错题分析、图片内容总结。注意:图片也不要包含隐私、涉密画面。
三、高阶阶段:API 调用、函数调用、Agent 工作流
这是从 “聊天使用” 升级到业务自动化的分水岭
1. API 基础
通过接口把 GPT 能力接入自己软件、小程序、企业系统;可以控制模型、温度 temperature、最大输出长度。
temperature(温度):0 = 严谨、稳定、少创意;1 = 发散、创意强,适合 brainstorm
top_p:控制采样范围,配合温度调节随机性
注意:按量计费,需要做好限流、缓存控制成本
2. Function Calling / 工具调用
让 GPT 自主调用外部工具:查数据库、调用搜索引擎、读取接口、计算、查询实时数据。解决原生 GPT 知识截止、无法获取实时信息的短板。
3. Agent 智能体
大模型自主规划任务、拆分步骤、循环调用工具、校验结果,自动完成复杂链式任务。典型场景:市场调研、自动报表生成、多步骤数据分析、客户自动接待。
4. RAG 检索增强生成(企业最常用落地方案)
原理:把自有文档(产品手册、合同、内部资料、知识库)存入向量数据库,用户提问时,先检索相关片段,再交给 GPT 基于资料回答。 ✅ 价值:减少幻觉、只用企业自有资料回答、不用重新微调大模型,成本更低。适用:企业知识库、客服问答、内部文档助手。
5. 微调 Fine-tuning
拿大量专属标注数据训练模型,固化风格、固定输出格式、学习垂直行业术语。对比 RAG:RAG 适合资料经常更新;微调适合固定风格、固定任务、高频标准化输出,成本更高。
四、精通阶段:工程落地、评估、安全与优化
1. 应用评估指标
不是看好不好看,重点看:
事实准确率(幻觉率)
任务完成率
召回、精准度(知识库问答场景)
响应速度、成本、token 消耗
一致性:相同输入多次输出是否稳定
2. 安全与内容风控
输入侧:提示注入防护(防止用户绕过设定、越狱指令)
输出侧:敏感内容过滤、事实校验
数据隐私:区分公有 GPT 和私有化部署;企业核心数据优先私有化大模型方案,不调用公共 API
提示注入风险示例:用户粘贴文本里暗藏指令,覆盖你预设的角色规则。
3. 性能 & 成本优化
压缩提示词,删掉冗余文字;
做结果缓存,重复问题不重复调用;
区分模型:简单任务用 3.5,复杂推理再上 4o;
精简返回内容,限制 max_tokens。
4. 主流落地架构路线对比
纯提示词:零开发,适合个人、临时使用
RAG + API:中小企业知识库、客服,首选方案
Agent + 工具链:自动化复杂业务流程
微调:垂直行业标准化任务
私有化部署:强数据合规、涉密企业
五、能力边界 & 常见误区(精通必须理解)
❌ GPT 不能保证事实正确,所有专业结论、数据、引用必须二次核验;
❌ 没有真实记忆,对话记忆只存在当前会话,新开对话全部清空(除非搭配向量库 / 数据库);
❌ 不具备真正理解、主观感受,只是概率文本生成;
❌ 实时信息有限,基础模型有知识截止时间,不联网就不知道最新新闻、行情;
✅ 它是效率工具,不是直接替代专家,适合辅助、初稿、梳理、检索、推演。
六、学习路线规划
第 1 阶段(1–3 天):注册上手,练习基础提问,熟练基础提示词模板
第 2 阶段(1–2 周):提示词工程,CoT、Few-shot、格式控制,多模态读图
第 3 阶段(2–4 周):学习 API、RAG 原理,搭建简易本地知识库 Demo
第 4 阶段:Agent、微调、评估、风控、项目落地
七、配套学习方向(延伸)
向量数据库(Chroma、Milvus)、LangChain、LlamaIndex、Prompt 评估框架、大模型安全、私有化部署。
- 上一页:车联网安全威胁详解
- 下一页:2025 手机对比推荐全解析
-
 LLM大语言模型典型案例分析|落地实战复盘
概述:本文聚焦2025-2026年已商业化落地、具备真实数据、可复用落地逻辑的四大LLM标杆案例,覆盖金融风控、工业智造、在线教育、智能客服四大核心赛道。统一采用「项目痛点→技术架构→落地流程→落地成效→现存问题→...
-
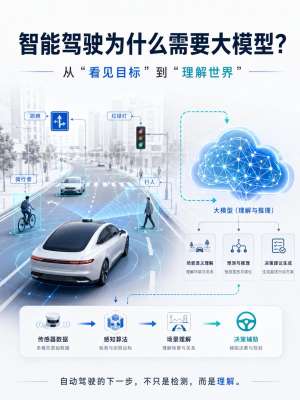 LLM大语言模型落地案例分析报告—以家用智能座舱系统为例
一、案例概述随着生成式人工智能技术快速迭代,LLM大语言模型已从通用对话场景,深度下沉至车载智能座舱垂直领域。传统车机语音系统多为固定指令匹配、语义理解僵化、交互生硬,无法满足家庭多成员...
-
 LLM大模型工具推荐2026完整版|全场景选型指南
2026 LLM选型核心标准:不再只看对话流畅度,重点看长文本理解、真实知识库RAG、多模态质量、Agent智能体能力、国产化合规、稳定输出。以下为目前全网综合体验最强、落地最稳、适配各行各业的主流LLM工具,分场景精准...
-
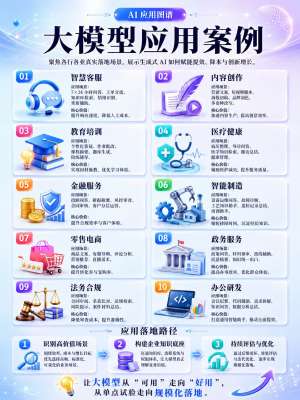 LLM大模型全行业应用场景(2026完整版|落地可用)
本文整理通用+政企+产业+ToB+ToC+车端+教育+医疗+文旅+开发运维全维度LLM落地场景,全部为当前可商业化、可项目落地的真实场景,无概念虚标,适合项目申报、方案撰写、产品规划、赛道调研使用。一、通用基础能力场景...
-
 LLM大语言模型深度解析|2026完整版全解
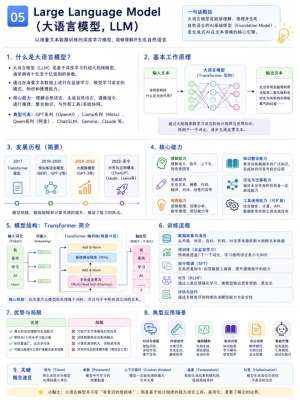
核心前言:2026年是大语言模型从通用对话工具彻底转向产业智能底座、Agent自主生产力的关键拐点。行业认知已全面升级:LLM不再是“会聊天的AI”,而是基于海量数据概率学习、具备语义理解、逻辑推理、工具调用、自主规划、...
-
 LLM大模型落地最佳实践|全指南
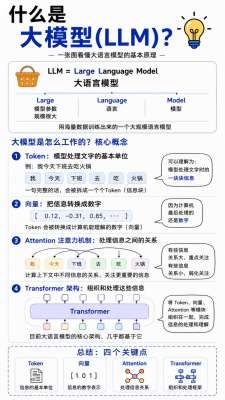
前言:大模型(LLM)已经从“技术demo”进入工业化、工程化、业务化落地阶段。绝大多数企业落地失败,并非模型能力不足,而是缺少标准化落地范式、Prompt混乱、向量库滥用、微调无策略、推理成本失控、幻觉风险未治理。本文总结行业...