LLM大模型全链路避坑指南(2026最新)
LLM大模型全链路避坑指南(2026最新)
核心前言:2026年LLM落地最大的问题不再是“能不能做”,而是怎么不踩坑、不超预算、不翻车、合规不违规、效果稳定可用。绝大多数企业大模型项目烂尾、效果不达预期、成本失控、上线后频发事故,均来自通用认知误区、选型错误、工程疏漏、合规缺失。本文汇总一线落地高频翻车点,按全流程拆解避坑标准,覆盖新手、研发、企业项目、生产上线全场景。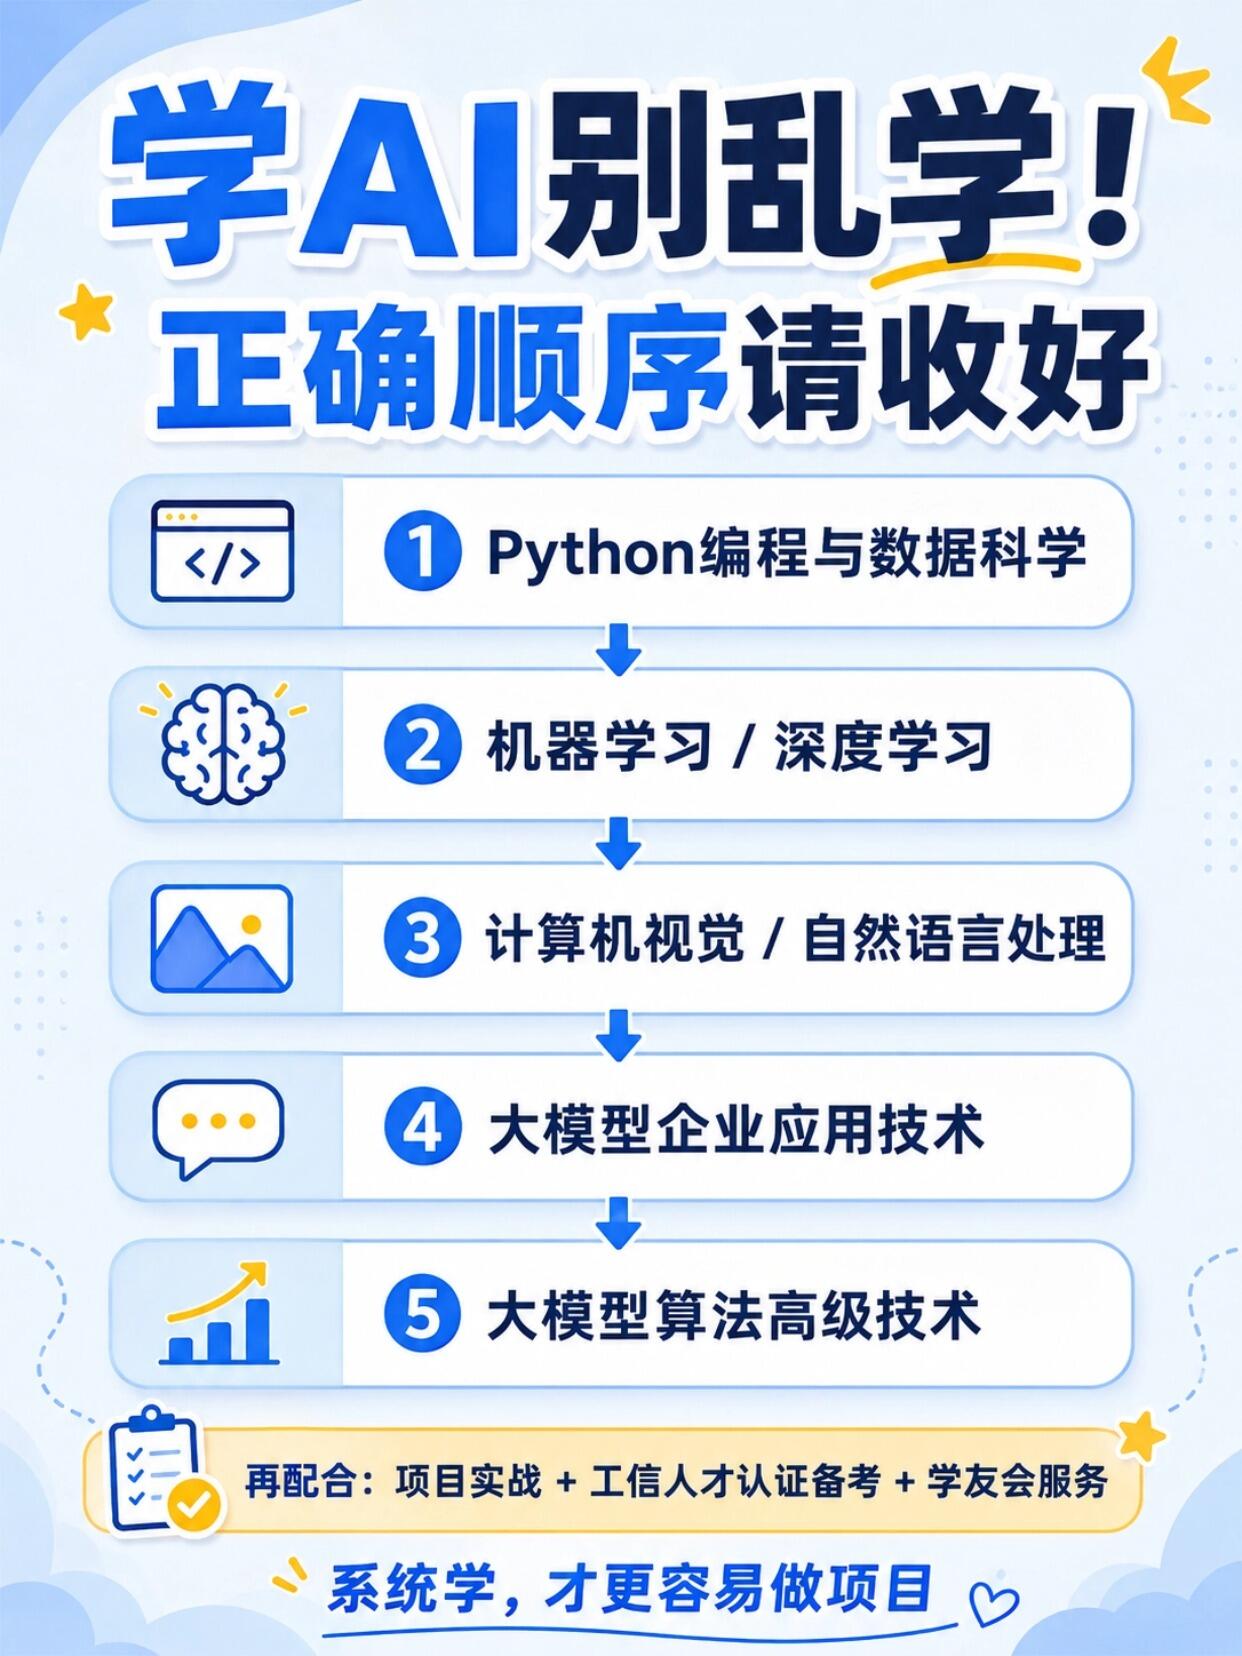
一、模型选型避坑(90%项目开局即翻车)
1. 拒绝“唯参数论”误区
大坑:认为参数越大效果越好,盲目上70B、100B大模型,导致推理昂贵、延迟高、迭代慢、运维压力大。
真相:2026年轻量化模型、垂直微调模型、专用行业模型,在细分场景准确率远超通用超大模型。通用大模型擅长对话创作,垂直业务、结构化输出、知识库问答,中小模型+RAG+微调性价比碾压大模型。
正确原则:简单对话用小模型、复杂推理用中型模型、极致逻辑推理/多模态才用顶级大模型。
2. 开源/闭源、本地/云端选型避坑
避坑1:涉密、政务、金融、企业私有数据,严禁直接调用公有云API,极易造成数据泄露、数据出境合规风险。
避坑2:普通初创项目、快速验证场景,不要盲目私有化部署,GPU成本、运维成本、适配成本远超API调用费用。
二、RAG知识库落地高频避坑(最容易看似能用、实则无效)
1. 知识库简单上传即上线误区
大坑:直接整文档投喂、无脑切片、固定chunk大小,导致上下文断裂、关键信息缺失、幻觉严重、答非所问。
正确做法:先清洗、去重、脱敏、分层切片,按章节语义拆分,配合重排序、关键词召回、多路检索,杜绝简单切片。
2. 只拼召回、不做过滤校验
大坑:检索到内容直接喂给大模型,包含过期信息、错误文档、冗余内容,模型被错误信息带偏。
必做步骤:增加时效性过滤、可信度校验、冲突内容比对、引用溯源,强制模型基于知识库作答,禁止自由发挥。
3. 忽略知识库更新机制
大坑:静态知识库一次性导入,政策、制度、业务更新后,模型持续输出旧答案,业务严重失真。
标准配置:建立增量更新、定时巡检、过期下线、版本回溯机制。
三、模型微调避坑(微调不是万能药)
1. 盲目全量微调
大坑:小场景、少量样本直接全量微调,算力消耗巨大、极易过拟合、泛化能力崩塌,上线后通用性极差。
正确方案:90%业务场景优先LoRA微调,轻量、低成本、不破坏底座、可快速迭代。
2. 训练数据不干净
脏数据、重复数据、错误样本、标注不一致,是微调效果差的第一原因。模型只会复刻数据错误,无法自我纠错。
微调前置铁律:数据去重、清洗、标准化输出格式、分层验证集、固定Schema。
3. 学习率与迭代失控
学习率过高快速过拟合,过低收敛极慢;无早停策略,导致模型越训越差。必须配置早停机制、学习率衰减、混合精度训练。
四、工程部署与并发避坑(上线必翻车点)
1. 开发环境直接上生产
致命坑:Ollama默认单请求串行处理,生产多用户并发直接排队、超时、卡死,大量团队直接裸上线导致服务瘫痪。
生产标准:企业生产必须使用 vLLM / Text Generation Inference 支持高并发、动态批处理。
2. 忽视显存与资源瓶颈
大模型未做量化、未开推理加速,单卡负载爆表、延迟飙升。
必开优化:KV Cache、FlashAttention2、动态量化、显存分片、推理缓存,可直接降本提速30%–70%。
3. 无熔断、无降级、无重试机制
大模型接口超时、报错、限流、网络波动时,前端直接报错、业务中断。生产环境必须配置:超时熔断、失败重试、降级兜底、日志全链路记录。
五、成本计费避坑(80%企业多花一半冤枉钱)
1. 不做Token缓存与复用
固定人设、固定系统提示词、长对话场景,每次重复传入,造成巨额Token浪费。开启Prompt缓存,固定前缀可节省70%输入成本。
2. 不分场景滥用高级模型
简单分类、提取、翻译、问答全部调用4o、顶级大模型,成本爆炸。
分层调用策略:简单任务小模型、复杂任务中模型、极复杂推理大模型,自动路由降级。
3. 无用量监控、无账单预警
批量请求、异常刷量、循环调用导致单日账单暴涨,无人感知。必须开启用量统计、阈值告警、IP限流、单日额度封顶。
六、安全漏洞避坑(极易被忽视的高危风险)
1. 提示词注入攻击
高危坑:用户输入恶意指令、覆写系统Prompt、越权问答、获取内部规则、泄露后台配置。
防护:输入清洗、指令校验、权限隔离、禁止用户修改系统基线提示词。
2. 开源框架自带漏洞
AnythingLLM、通用爬虫组件存在SSRF漏洞,可被攻击者抓取服务器内网元数据、穿透内网、泄露敏感文件。所有开源LLM应用上线前必须做漏洞扫描、关闭无用爬虫权限。
3. 默认密钥、默认密码裸奔
大量项目上线保留SECRET_KEY、INIT_PASSWORD默认值,直接被批量爆破接管后台,属于最高危生产事故。
七、合规避坑(2026严查红线)
数据合规红线:企业私有数据、用户隐私、业务数据禁止出境、禁止无脱敏上传公有云大模型。
内容合规红线:LLM生成内容必须可溯源、可审核、可过滤,禁止生成违规、虚假、误导性内容,企业AI应用需留存交互日志。
模型备案红线:面向公众服务的大模型应用必须完成备案,未备案不得商用上线。
训练数据红线:禁止未经授权抓取互联网版权数据、私有数据训练模型,避免版权纠纷。
八、业务落地避坑(项目不烂尾核心准则)
避坑1:不要追求100%完美效果,LLM天生存在概率性误差,项目必须容忍可控误差、建立人工复核机制。
避坑2:不做全场景万能AI,越万能越不稳定,垂直场景、窄口径、强约束才是可落地项目。
避坑3:只演示不验收,无量化指标。上线前必须明确准确率、召回率、幻觉率、响应延迟四大验收指标。
避坑4:忽略运维迭代,大模型应用不是一次性开发,需要持续数据更新、模型微调、规则迭代、问题复盘。
九、2026年LLM落地终极避坑总结
1. 选型不迷信大模型:场景匹配优先,轻量化+微调+RAG是性价比最高方案。
2. 工程不裸奔上线:并发、缓存、熔断、降级、安全加固缺一不可。
3. 数据不裸传裸存:脱敏、本地化、增量更新、溯源校验是底线。
4. 成本不盲目堆叠:分层调用、缓存复用、用量监控,杜绝资源浪费。
5. 合规不踩红线:数据不出境、内容可审核、应用可备案、漏洞全修复。
6. 业务不追求万能:窄场景、强约束、可量化、可迭代,才是可持续落地的AI项目。
-
 LLM大语言模型典型案例分析|落地实战复盘
概述:本文聚焦2025-2026年已商业化落地、具备真实数据、可复用落地逻辑的四大LLM标杆案例,覆盖金融风控、工业智造、在线教育、智能客服四大核心赛道。统一采用「项目痛点→技术架构→落地流程→落地成效→现存问题→...
-
 LLM大语言模型落地案例分析报告—以家用智能座舱系统为例
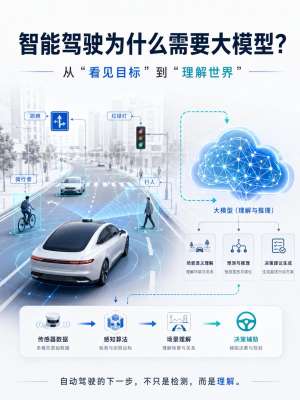
一、案例概述随着生成式人工智能技术快速迭代,LLM大语言模型已从通用对话场景,深度下沉至车载智能座舱垂直领域。传统车机语音系统多为固定指令匹配、语义理解僵化、交互生硬,无法满足家庭多成员...
-
 LLM大模型工具推荐2026完整版|全场景选型指南
2026 LLM选型核心标准:不再只看对话流畅度,重点看长文本理解、真实知识库RAG、多模态质量、Agent智能体能力、国产化合规、稳定输出。以下为目前全网综合体验最强、落地最稳、适配各行各业的主流LLM工具,分场景精准...
-
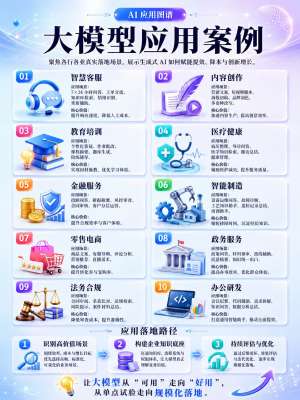 LLM大模型全行业应用场景(2026完整版|落地可用)
本文整理通用+政企+产业+ToB+ToC+车端+教育+医疗+文旅+开发运维全维度LLM落地场景,全部为当前可商业化、可项目落地的真实场景,无概念虚标,适合项目申报、方案撰写、产品规划、赛道调研使用。一、通用基础能力场景...
-
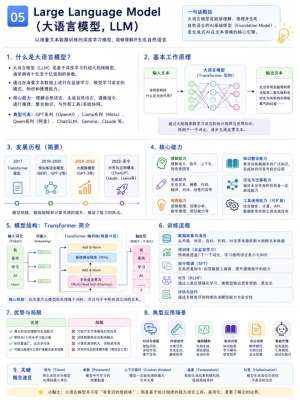 LLM大语言模型深度解析|2026完整版全解
核心前言:2026年是大语言模型从通用对话工具彻底转向产业智能底座、Agent自主生产力的关键拐点。行业认知已全面升级:LLM不再是“会聊天的AI”,而是基于海量数据概率学习、具备语义理解、逻辑推理、工具调用、自主规划、...
-
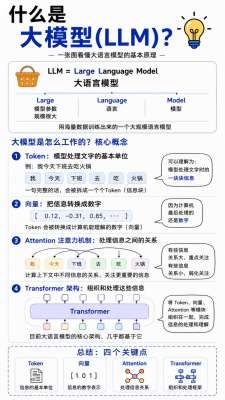 LLM大模型落地最佳实践|全指南
前言:大模型(LLM)已经从“技术demo”进入工业化、工程化、业务化落地阶段。绝大多数企业落地失败,并非模型能力不足,而是缺少标准化落地范式、Prompt混乱、向量库滥用、微调无策略、推理成本失控、幻觉风险未治理。本文总结行业...