LLM大语言模型完整教程(2026零基础全体系版)
LLM大语言模型完整教程(2026零基础全体系版)
教程定位:全网最通俗易懂、无门槛、体系闭环的LLM实战教程。从底层原理到企业级落地,不堆砌公式、不废话,从零搞懂大语言模型是什么、怎么工作、怎么用、怎么开发、怎么部署,适配新手入门、AI应用开发、面试进阶、工程落地全场景。
学习路线:基础认知 → 核心原理 → 模型架构 → 提示词工程 → RAG检索增强 → Agent智能体 → 微调技术 → 部署优化 → 安全避坑 →
实战项目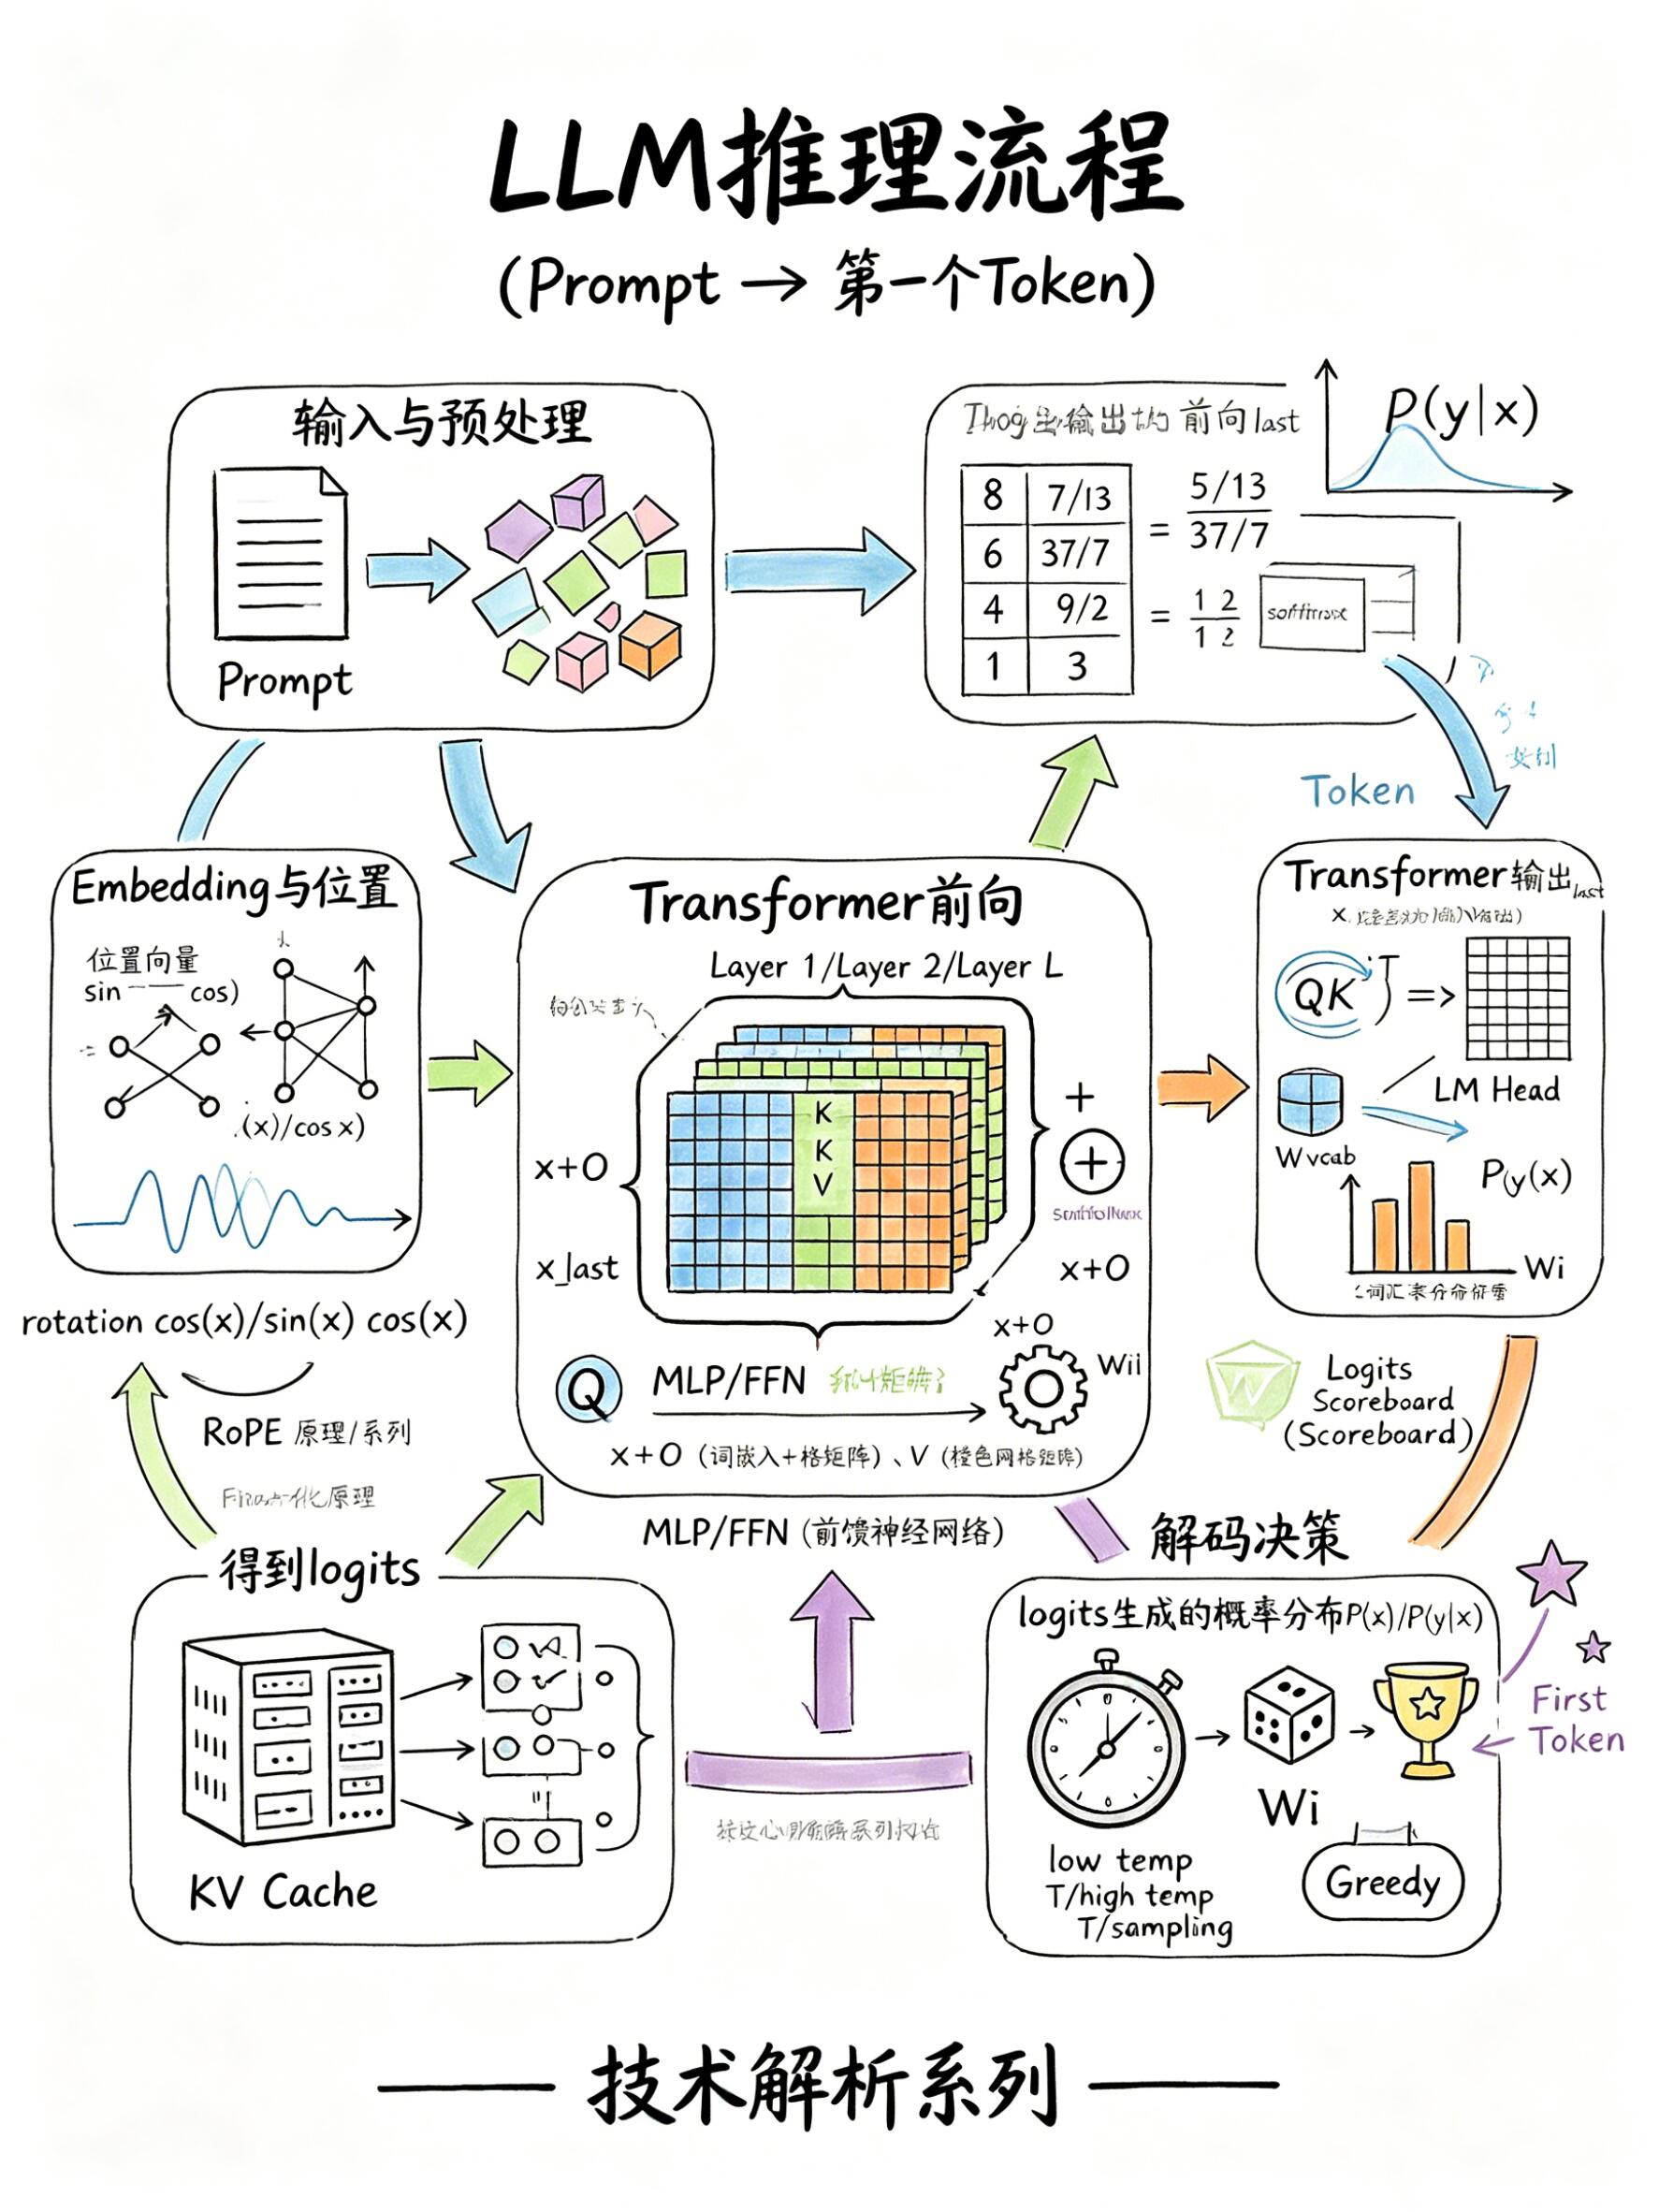
第一章 LLM基础认知:彻底搞懂大语言模型
1.1 什么是LLM(大语言模型)
LLM全称Large Language Model,大语言模型,是基于Transformer架构、通过海量文本数据预训练、具备通用语言理解与生成能力的人工智能模型。
核心本质:基于前文概率预测下一个字。所有对话、写作、推理、编程、翻译能力,全部来自“海量文本学习+逐字概率生成”。
通俗理解:AI读完全网文本,学会人类语言逻辑、知识、语法、思维习惯,根据上下文自动续写最合理的内容。
1.2 LLM和传统NLP的核心区别
传统NLP:任务拆分、人工特征、专项模型,翻译、分词、问答各做各的,无法通用。
LLM大模型:大一统通用能力,一个模型搞定理解、生成、推理、翻译、代码、总结、创作,支持零样本、少样本任务。
1.3 LLM核心能力(2026通用标准)
语言能力:对话、写作、改写、润色、翻译、摘要、纠错
逻辑推理:数学计算、逻辑推导、方案拆解、问题分析
工具调用:联网搜索、代码执行、知识库查询、函数调用
记忆上下文:多轮对话、语境延续、长文本理解
泛化能力:未见过的新任务、新问题也能自主处理
1.4 LLM能力边界(新手必懂避坑)
无实时联网能力(原生模型知识库截止训练时间)
存在幻觉问题:一本正经编造虚假数据、案例、文献
上下文有限,超长文本易遗忘、跑偏
复杂数学、精密逻辑容易出错
不具备真实意识、情感、自主认知,只是概率生成
第二章 LLM底层核心原理(零基础听懂)
2.1 Transformer核心逻辑(LLM的地基)
当前所有主流大模型(GPT、Llama、Qwen、DeepSeek)全部基于Transformer架构,核心两大模块:编码器Encoder、解码器Decoder。
Encoder编码:理解输入文本、提取语义、捕捉上下文关系(多用于理解类任务)
Decoder解码:逐字生成输出文本(LLM核心生成模块)
主流LLM均为Decoder-only架构,专注文本生成,更适配对话、创作、推理场景。
2.2 注意力机制(Attention):大模型的核心智慧
注意力机制作用:让模型读懂字词之间的关联关系,分清上下文主次、语义逻辑、指代关系。
自注意力核心逻辑:生成每个字时,模型会自动权重计算前文所有字词的重要程度,精准理解语境,解决歧义、指代、长文本关联问题。
2.3 Token机制(必须掌握)
模型不认识汉字、单词,只认识Token(词元)。文本会被分词器拆分为最小单元,再转为数字向量输入模型。
1个中文汉字≈2个Token
1个英文单词≈1–3个Token
上下文窗口=最大可容纳Token数量,决定能处理多长文本
所有限流、计费、上下文长度限制,全部基于Token计算。
2.4 LLM三阶段训练流程(行业标准)
阶段1:预训练 Pre-training(打底通识)
投喂全网海量公开文本,模型自主学习语法、知识、逻辑、语言规律,完成“通识教育”。目标:学会通用语言能力与基础常识。
阶段2:有监督微调 SFT(对齐任务)
投喂高质量人工对话、指令数据,让模型学会按照人类指令输出,从“会说话”变成“听得懂、答得对”。
阶段3:人类反馈强化学习 RLHF(对齐价值观)
通过人类打分、AI打分筛选优质回答,强化学习优化输出,让模型更安全、更真实、更有用、更贴合人类偏好,减少劣质输出、有害内容、幻觉。
第三章 LLM关键参数与生成策略
3.1 核心超参通俗解读
Temperature温度:控制随机性。0=完全严谨、固定答案;1=创意自由、发散度高。写代码、计算用低温,创作用高温。
Top-P:核采样,控制候选词范围,越小答案越规整,越大越多元。
Max_tokens:单次最大生成字数,限制输出长度。
上下文窗口Context Window:决定多轮记忆、长文本处理能力。
3.2 模型幻觉产生根源与缓解方案
根源:模型只学习概率分布,不具备真实记忆与事实认知,在知识盲区会优先“通顺生成”而非“承认不会”。
缓解方法:低温采样、Prompt约束、RAG知识库实时检索、引用来源标注、事实校验机制。
第四章 Prompt提示词工程(零基础实战核心)
Prompt是人与大模型的唯一交互语言,Prompt质量直接决定输出质量,是最低成本提升AI能力的方式。
4.1 万能Prompt五要素公式
角色定位 + 任务指令 + 输入素材 + 输出要求 + 约束规则
角色:你是资深行业专家/工程师/文案师
任务:明确具体要做什么
素材:粘贴原文、数据、背景
输出:格式、字数、结构、风格、语言
约束:禁止编造、必须严谨、逐条输出
4.2 四大主流Prompt范式
Zero-shot零样本:直接提问,无需示例
Few-shot少样本:给1–3个示例,模型快速模仿格式与逻辑
CoT思维链:让模型“分步思考、先推导再答案”,大幅提升推理正确率
Self-consistency自洽性:多次推理、择优输出,解决复杂逻辑出错问题
4.3 高频场景Prompt模板(直接复用)
文案创作、工作总结、论文改写、数据复盘、代码生成、问题分析、方案撰写、面试问答、学习答疑
第五章 RAG检索增强生成(企业级刚需技术)
RAG是解决大模型幻觉、知识滞后、私有数据无法调用的最优工程方案,2026年企业落地首选架构。
5.1 RAG核心原理
不修改模型参数,通过外部知识库检索+大模型生成,让AI基于私有文档、实时数据、最新资料回答问题,彻底解决知识过期、编造信息问题。
核心逻辑:检索真实资料 → 投喂给模型 → 模型基于资料生成答案
5.2 RAG完整工程流程
文档加载:PDF、Word、TXT、网页、知识库批量导入
文本切片Chunk:长文本拆分适配Token窗口
Embedding向量化:文本转为向量存入向量数据库
相似度检索:用户提问→向量匹配→召回相关片段
上下文组装:问题+检索内容拼接Prompt
LLM生成回答:基于真实资料输出精准答案
5.3 RAG优化进阶技巧
切片重叠优化、关键词+向量混合检索
重排序Rerank提升精准度
问答对生成、文档预处理清洗
多轮记忆RAG、增量更新知识库
第六章 LLM Agent智能体(高阶自动化架构)
Agent是让LLM从“被动问答”升级为主动思考、自主规划、工具调用、自动执行的核心架构,是2026年AI应用爆发核心方向。
6.1 Agent核心逻辑
LLM不再只做生成,而是充当大脑调度中心,自主判断任务、拆解步骤、选择工具、执行动作、复盘迭代。
6.2 Agent五大核心模块
规划Planning:复杂任务拆解分步执行
记忆Memory:短期对话记忆+长期知识库记忆
工具调用Tool Use:联网、代码、检索、计算、接口调用
反思Reflection:自我纠错、迭代优化输出
行动Action:对接业务系统、自动执行任务
6.3 主流Agent框架
LangChain、LlamaIndex、AutoGPT、Coze扣子、Dify,零基础优先Dify可视化搭建,进阶学习LangChain工程开发。
第七章 LLM微调技术(定制专属模型)
RAG是外挂知识,微调是内化能力,适合行业话术、专属风格、固定任务、垂直场景定制。
7.1 微调分类
全量微调:更新全部参数,效果最好、算力成本高
参数高效微调PEFT:LoRA/IA3,低成本、小算力、快速落地,企业主流方案
7.2 微调完整流程
数据采集清洗 → 标准化指令数据集构建 → 模型加载 → LoRA微调 → 合并权重 → 效果评测 → 部署上线
7.3 RAG与微调怎么选(实战准则)
知识更新、资料查询:优先RAG(低成本、随时更新)
固定风格、固定话术、专属任务:优先微调(内化能力、输出稳定)
企业最优解:RAG+微调双架构结合
第八章 LLM工程部署与优化
8.1 部署形态
API调用:公有云模型快速接入(最简、新手入门)
本地私有化部署:开源模型离线部署、数据安全可控
轻量化部署:量化压缩、推理加速,适配边缘设备
8.2 性能优化核心方案
模型量化(4bit/8bit)降低显存占用
KV缓存加速推理、提升响应速度
批量请求、异步调度提升并发能力
长文本窗口扩展、上下文优化
第九章 LLM安全与风险管控(企业必备)
9.1 核心风险
幻觉虚假输出、误导决策
Prompt注入、越权调用、漏洞攻击
隐私数据泄露、敏感信息外泄
违规内容生成、合规风险
9.2 安全防护方案
输入脱敏、敏感词过滤、Prompt防火墙
输出内容审核、事实校验、来源溯源
权限分级、工具调用白名单、日志审计
第十章 2026最新LLM学习路线与实战项目
10.1 零基础3个月进阶路线
第1月:基础原理+Prompt工程,熟练各类提示词模板
第2月:RAG开发+向量数据库,搭建私有知识库问答系统
第3月:Agent开发+LoRA微调+部署落地,完成企业级项目
10.2 必做实战项目(可写进简历)
企业文档智能问答RAG系统
自动化办公Agent(文档处理、数据分析、邮件汇总)
垂直行业专属微调模型(教育/金融/政务/电商)
多智能体协同任务平台
第十一章 主流LLM模型选型指南(2026最新)
通用对话:GPT-4o、Claude 3.5、通义千问、文心一言
开源本地部署:Llama3、Qwen、DeepSeek、GLM
长文本场景:Claude、Qwen长上下文模型
代码开发:DeepSeek-Coder、GPT-4o
轻量化边缘部署:MiniCPM、Qwen-small
终极总结
LLM学习体系可归纳为三层:底层原理(Transformer+训练逻辑)→ 应用能力(Prompt+RAG+Agent)→ 工程能力(微调+部署+安全优化)。2026年大模型竞争不再是单纯模型能力比拼,而是场景落地、工程优化、安全合规、业务赋能的综合能力比拼,掌握全链路体系,即可胜任AI应用开发、大模型工程、AI产品、行业解决方案等岗位。
-
 LLM大语言模型典型案例分析|落地实战复盘
概述:本文聚焦2025-2026年已商业化落地、具备真实数据、可复用落地逻辑的四大LLM标杆案例,覆盖金融风控、工业智造、在线教育、智能客服四大核心赛道。统一采用「项目痛点→技术架构→落地流程→落地成效→现存问题→...
-
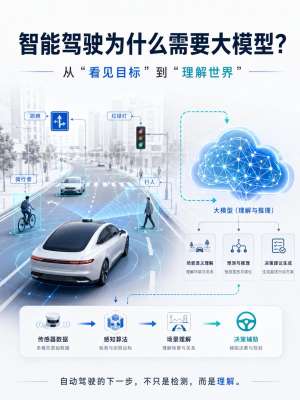 LLM大语言模型落地案例分析报告—以家用智能座舱系统为例
一、案例概述随着生成式人工智能技术快速迭代,LLM大语言模型已从通用对话场景,深度下沉至车载智能座舱垂直领域。传统车机语音系统多为固定指令匹配、语义理解僵化、交互生硬,无法满足家庭多成员...
-
 LLM大模型工具推荐2026完整版|全场景选型指南
2026 LLM选型核心标准:不再只看对话流畅度,重点看长文本理解、真实知识库RAG、多模态质量、Agent智能体能力、国产化合规、稳定输出。以下为目前全网综合体验最强、落地最稳、适配各行各业的主流LLM工具,分场景精准...
-
 LLM大模型全行业应用场景(2026完整版|落地可用)
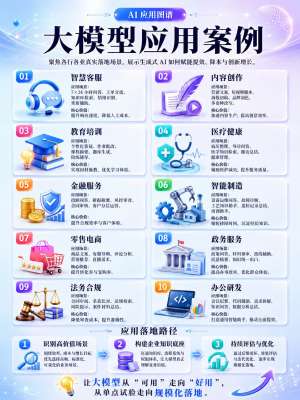
本文整理通用+政企+产业+ToB+ToC+车端+教育+医疗+文旅+开发运维全维度LLM落地场景,全部为当前可商业化、可项目落地的真实场景,无概念虚标,适合项目申报、方案撰写、产品规划、赛道调研使用。一、通用基础能力场景...
-
 LLM大语言模型深度解析|2026完整版全解
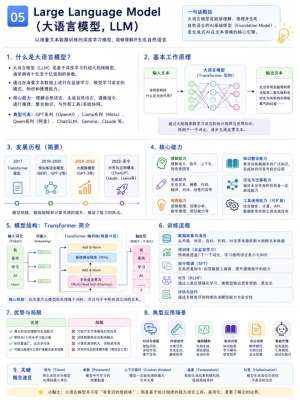
核心前言:2026年是大语言模型从通用对话工具彻底转向产业智能底座、Agent自主生产力的关键拐点。行业认知已全面升级:LLM不再是“会聊天的AI”,而是基于海量数据概率学习、具备语义理解、逻辑推理、工具调用、自主规划、...
-
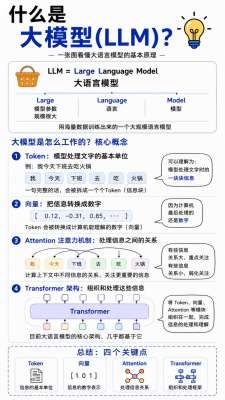 LLM大模型落地最佳实践|全指南
前言:大模型(LLM)已经从“技术demo”进入工业化、工程化、业务化落地阶段。绝大多数企业落地失败,并非模型能力不足,而是缺少标准化落地范式、Prompt混乱、向量库滥用、微调无策略、推理成本失控、幻觉风险未治理。本文总结行业...